Étapes pour intégrer l'IA dans une application
- Commencez par un cas d’usage restreint
- Choisissez votre approche d’intégration
- Mettez en place une architecture backend sécurisée
- Choisissez votre schéma de connexion aux données
- Exigez des sorties structurées
- Ajoutez des garde-fous de production avant le déploiement
Les fonctionnalités d’IA qui étaient autrefois impressionnantes, comme celles capables de résumer un long document ou de répondre à une question en langage courant, sont désormais attendues. Pour la plupart des équipes, la question n’est pas de savoir s’il faut ajouter de l’IA à leur application, mais comment le faire sans créer de nouveaux problèmes.
Ajouter de l’IA à une application existante n’est pas aussi simple que de coller une clé API dans votre code front-end. Réalisé sans précaution, l’ajout d’une fonctionnalité d’IA peut introduire des problèmes difficiles à corriger par la suite. Cela peut entraîner des problèmes de latence, c’est-à-dire que les réponses de l’IA prennent plusieurs secondes par rapport à l’immédiateté à laquelle les utilisateurs sont habitués. De plus, la plupart des fournisseurs facturent chaque requête, de sorte que votre facture augmente à mesure que l’utilisation croît. L’IA peut aussi se comporter de manière imprévisible, votre application doit donc disposer de mécanismes de protection pour gérer les réponses inattendues.
Si vous êtes développeur, chef de produit ou directeur technique et que vous souhaitez apprendre à ajouter de l’IA à une application existante, ce tutoriel vous guidera à travers les étapes sans endommager votre infrastructure actuelle. Nous aborderons l’intégralité du cycle de vie d’une fonctionnalité d’IA, du choix de la première fonctionnalité dans laquelle vous souhaitez intégrer l’IA à l’application des sorties JSON structurées et des réponses en streaming. À la fin, vous aurez la certitude que ce que vous avez construit ne tombera pas en panne.
1. Commencez par un cas d’usage restreint
L’erreur la plus fréquente que commettent les équipes lorsqu’elles apprennent à créer un assistant IA entièrement autonome est de voir trop grand, trop vite. Vous devriez commencer par un seul workflow restreint et prévisible. Ainsi, vous pouvez le tester et comprendre ce qui s’est passé en cas de problème. Cette tâche pourrait simplement consister à résumer une note ou à catégoriser un ticket d’assistance, offrant à votre équipe produit un moyen contrôlé d’observer le comportement de l’IA avant son déploiement complet.
Voici quelques fonctionnalités à tester, selon le type d’application que vous développez :
| App type | Ideal first AI feature | AI model type |
|---|---|---|
|
Notes et productivité |
Résumer un document ou une note en quelques points clés |
LLM (génération de texte) |
|
Support client |
Catégoriser un ticket entrant par sujet et par urgence |
LLM (classification) |
|
E-commerce |
Répondre aux questions sur les produits à partir de votre catalogue et de vos FAQ |
LLM avec génération augmentée par récupération (RAG) |
|
Finance |
Signaler les transactions inhabituelles à des fins de vérification |
Modèle prédictif (détection d’anomalies) |
Chacune de ces fonctionnalités a une portée restreinte et un résultat vérifiable, ce qui en fait des points de départ sûrs.
2. Choisissez votre approche d’intégration
Une fois que vous avez choisi la fonctionnalité par laquelle commencer, vous devrez décider de la voie technique que vous emprunterez pour connecter le modèle. Il existe trois approches principales :
- API d’IA en tant que service : Vous envoyez des requêtes à un modèle hébergé par un fournisseur tel qu’OpenAI, Anthropic ou Google. C’est le moyen le plus rapide de démarrer, car il n’y a aucune infrastructure à gérer, et les API d’IA pour les applications mobiles fonctionnent de la même manière que pour les applications web. En contrepartie, vous avez moins de contrôle et un coût qui augmente à chaque requête.
- Modèles auto-hébergés : Vous exécutez un modèle ouvert sur vos propres serveurs. Cela vous donne un contrôle total et peut réduire les coûts à grande échelle, et c’est la voie à suivre pour l’intégration d’un modèle d’IA personnalisé lorsque la confidentialité des données ou le réglage fin est important. En échange, vous assumez un véritable travail d’infrastructure et de maintenance.
- Kits de développement logiciel et frameworks d’IA : Une intégration LangChain ou un framework similaire ajoute une couche entre votre application et le modèle qui gère les schémas courants, notamment la récupération et l’appel d’outils, de sorte que vous écrivez moins de code de connexion vous-même. Le coût, c’est une dépendance supplémentaire à apprendre et à maintenir à jour, ainsi qu’une visibilité moindre sur ce que le framework fait entre votre application et le modèle.
3. Mettez en place une architecture backend sécurisée
Il existe une règle qui compte plus que toute autre lorsque vous apprenez comment intégrer l’IA dans une application : ne laissez jamais votre application communiquer directement avec un fournisseur d’IA.
Tout ce qui se trouve dans votre code front-end, qu’il s’agisse d’une application web dans le navigateur ou d’une application mobile sur un appareil, peut être lu par les personnes qui l’utilisent. Votre clé API secrète se trouverait dans ce code, et il est facile de l’extraire du trafic réseau ou du bundle de l’application. Une fois que quelqu’un dispose de votre clé, il peut exécuter des requêtes sur votre compte jusqu’à épuisement de votre budget. C’est l’erreur la plus fréquente et la plus coûteuse en matière d’architecture backend d’IA.
Au lieu de cela, faites transiter chaque requête par votre propre back end afin de pouvoir garder votre clé API sécurisée, de contrôler les coûts et de valider les réponses de l’IA avant que les utilisateurs ne les voient. Voici à quoi ressemble ce flux :
- Action de l’utilisateur : Quelqu’un clique sur Résumer dans l’interface de votre application.
- Front end : Votre application envoie la requête à votre propre back end, et non au fournisseur d’IA.
- Back end : Votre serveur authentifie l’utilisateur, applique des limites de débit et joint la clé API secrète, qui ne réside qu’ici.
- Fournisseur d’IA : Le modèle traite la requête et renvoie une réponse.
- Back end : Votre serveur valide et nettoie cette réponse, puis la met en forme pour votre application.
- Front end : Votre application affiche à l’utilisateur le résultat propre et vérifié.
Faire transiter les requêtes par votre propre serveur ajoute une étape, mais c’est ce qui rend tout le reste possible. Comme chaque requête passe par votre serveur, la clé reste cachée, les utilisateurs sont limités quant à la fréquence à laquelle ils peuvent appeler la fonctionnalité, et la réponse de l’IA est vérifiée avant que votre application ne la montre à qui que ce soit.
4. Choisissez votre schéma de connexion aux données
L’étape suivante pour l’intégration de votre modèle d’IA personnalisé consiste à déterminer quelle part des données de votre application l’IA peut voir et utiliser. Il existe trois schémas standard qui diffèrent par ce qu’ils peuvent faire et par la quantité de travail nécessaire à leur mise en place :
- Prompt uniquement : Vous incluez tout ce dont le modèle a besoin directement dans le prompt. Si un utilisateur demande de résumer une note, vous envoyez la note accompagnée de l’instruction. C’est le schéma le plus simple et le choix par défaut approprié pour les tâches autonomes, mais il ne fonctionne que lorsque les données pertinentes sont suffisamment petites pour tenir dans le prompt.
- RAG : Lorsque l’IA doit fournir une réponse à partir d’une grande quantité d’informations, comme votre catalogue de produits, votre centre d’aide ou vos documents internes, vous ne pouvez pas tout faire tenir dans chaque prompt. Le RAG résout ce problème en recherchant dans vos données les éléments les plus pertinents pour la question, puis en transmettant uniquement ceux-ci dans le prompt. C’est ce qui permet à une IA de répondre avec précision à partir de votre propre contenu au lieu de deviner, et c’est l’approche standard pour un assistant intégré à l’application et bien informé. En contrepartie, vous avez généralement besoin d’une base de données vectorielle et d’un pipeline de récupération pour que cela fonctionne.
- Appel de fonction ou d’outil : Le modèle peut déclencher des actions dans votre application (par exemple, vérifier l’état d’une commande, réserver un créneau, extraire des données en temps réel) en renvoyant une requête structurée que votre back end exécute. C’est le schéma le plus puissant et celui vers lequel se tourner lorsque l’IA doit faire quelque chose, et pas seulement dire quelque chose.
Pro Tip
Si vous souhaitez intégrer un assistant bien informé à votre application existante, utilisez les assistants IA de Jotform. Vous pouvez entraîner instantanément un assistant simplement en téléversant vos PDF, vos liens de site web ou vos fichiers texte, puis en intégrant de manière transparente cet assistant entraîné directement dans l’interface de votre application, sans aucune base de données vectorielle complexe requise.
5. Exigez des sorties structurées
Le « prompting à l’instinct », c’est-à-dire le fait de compter sur le modèle pour répondre par des phrases en langage courant, s’effondre dès l’instant où votre application doit lire la sortie comme des données plutôt que comme du texte. Si vous demandez au modèle de catégoriser un ticket d’assistance et qu’il répond « Bien sûr ! La catégorie est Facturation », votre code doit extraire « Facturation » de cette phrase. La réponse suivante pourrait être formulée d’une tout autre manière, rendant cette extraction peu fiable.
La solution consiste à exiger des sorties structurées, en utilisant un schéma JSON pour que le modèle renvoie à chaque fois un objet strict et lisible par machine comme {“category”: “billing”, “priority”: “high”}. Votre back end peut alors l’analyser de la même manière à chaque requête, sans écrire de logique d’analyse de texte fragile ni risquer un plantage lorsque la formulation change.
6. Ajoutez des garde-fous de production avant le déploiement
Avant la mise en ligne de la fonctionnalité, mettez en place quelques mesures de protection. Chaque mesure de protection prévient un problème précis qui est plus difficile à corriger une fois la fonctionnalité en ligne et utilisée par les gens.
Voici les vérifications de sécurité obligatoires à mettre en œuvre avant de déployer la fonctionnalité en production :
- Limites de taille des entrées : Plafonnez la quantité de texte qu’un utilisateur peut envoyer dans une seule requête. Sans limite, une entrée surdimensionnée peut faire grimper vos coûts ou dépasser la fenêtre de contexte du modèle et échouer.
- Limites de débit : Restreignez le nombre de requêtes qu’un même utilisateur peut effectuer dans une fenêtre donnée. Cela protège votre budget contre les boucles accidentelles et les abus délibérés, et empêche un seul utilisateur intensif de dégrader l’expérience de tous les autres.
- Historique des conversations : Si votre fonctionnalité est un chat, décidez de la quantité de contexte antérieur que vous renvoyez avec chaque requête. Trop peu, et l’IA perd le fil ; trop, et chaque requête devient plus lente et plus coûteuse.
- Streaming (SSE) : Pour tout ce qui dépasse une réponse courte, diffusez la réponse jeton par jeton en utilisant les événements envoyés par le serveur au lieu de faire attendre l’utilisateur pour obtenir l’ensemble. Cela ne rend pas le modèle plus rapide, mais cela donne à la fonctionnalité une impression de réactivité plutôt que de blocage.
Comment surveiller et faire évoluer votre fonctionnalité d’IA
Une fois la fonctionnalité en ligne, vous avez besoin de visibilité sur son comportement. Journalisez les détails qui vous indiquent où commencent les problèmes, tels que la longueur du prompt, la latence des réponses et les taux d’erreur, afin de pouvoir repérer un ralentissement ou un pic avant que les utilisateurs ne le signalent.
Prévoyez aussi les défaillances. Les fournisseurs d’IA connaissent des pannes, alors concevez une solution de repli pour ce que votre application affiche lorsque le modèle est indisponible, plutôt que de laisser les utilisateurs face à un écran défaillant. Une fois votre première fonctionnalité stable et bien comprise, vous pouvez commencer en toute sécurité à vous étendre vers des flux de travail d’assistants IA plus complexes.
Vous n’avez pas encore d’application ? Faites complètement l’impasse sur le code
Si vous êtes arrivé jusqu’ici et que Node.js, les routes backend et l’architecture d’API commencent à représenter plus que ce que vous aviez prévu, voici une question à vous poser : est-ce que je veux construire tout cela moi-même à partir de zéro ?
De nombreuses applications qui exploitent l’IA ne sont pas des produits complexes. Si vous avez simplement besoin d’un portail interne d’entreprise, d’un outil de collecte des demandes clients ou d’un répertoire intelligent dans lequel votre équipe peut effectuer des recherches, engager un développeur pour le construire peut coûter beaucoup d’argent et de temps, alors que vous pourriez le mettre en place vous-même en une après-midi.
Si vous souhaitez créer une application sans codage, le générateur d’applications de Jotform vous permet de décrire l’application que vous voulez en langage courant et de générer une version fonctionnelle avec des fonctionnalités d’IA que vous pouvez personnaliser et partager, déjà intégrées. Il n’y a aucun back end à sécuriser, aucune clé API à cacher et aucun pipeline à maintenir, car tout est pris en charge pour vous.
Voici à quelle vitesse tout se met en place :
- Ouvrez le générateur d’applications de Jotform et décrivez votre application. Indiquez-lui ce dont vous avez besoin en une ou deux phrases, comme « un portail interne de demandes informatiques avec un assistant intelligent qui répond aux questions courantes ».
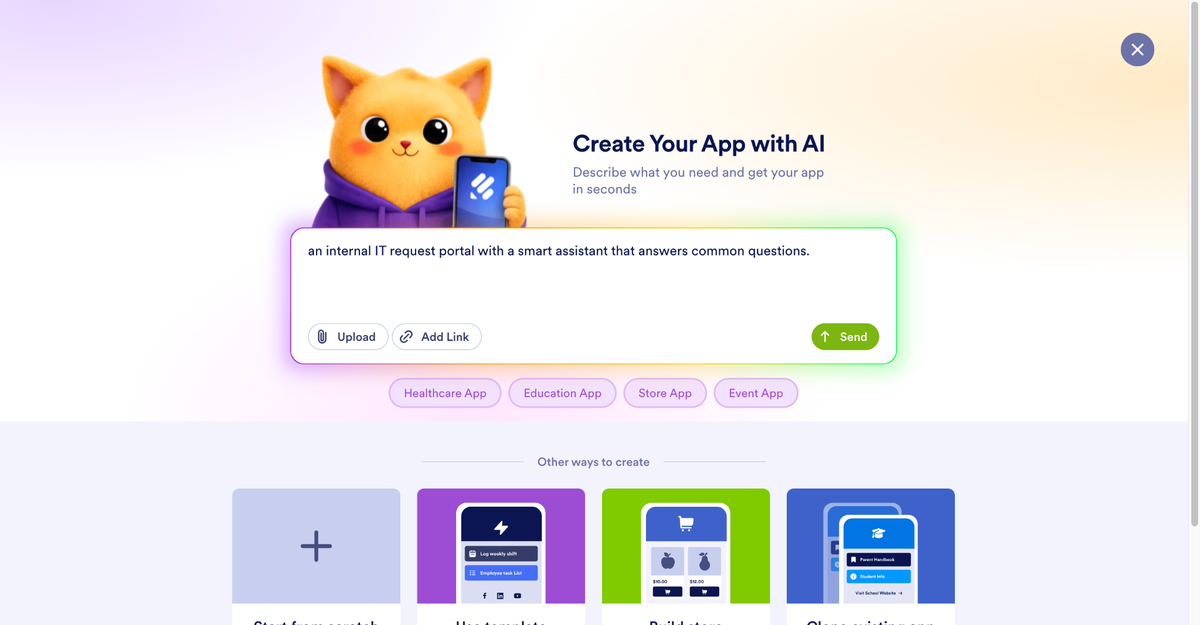
- Examinez l’application générée. En une minute environ, vous disposerez d’une application fonctionnelle avec des pages, des formulaires et une navigation déjà en place.
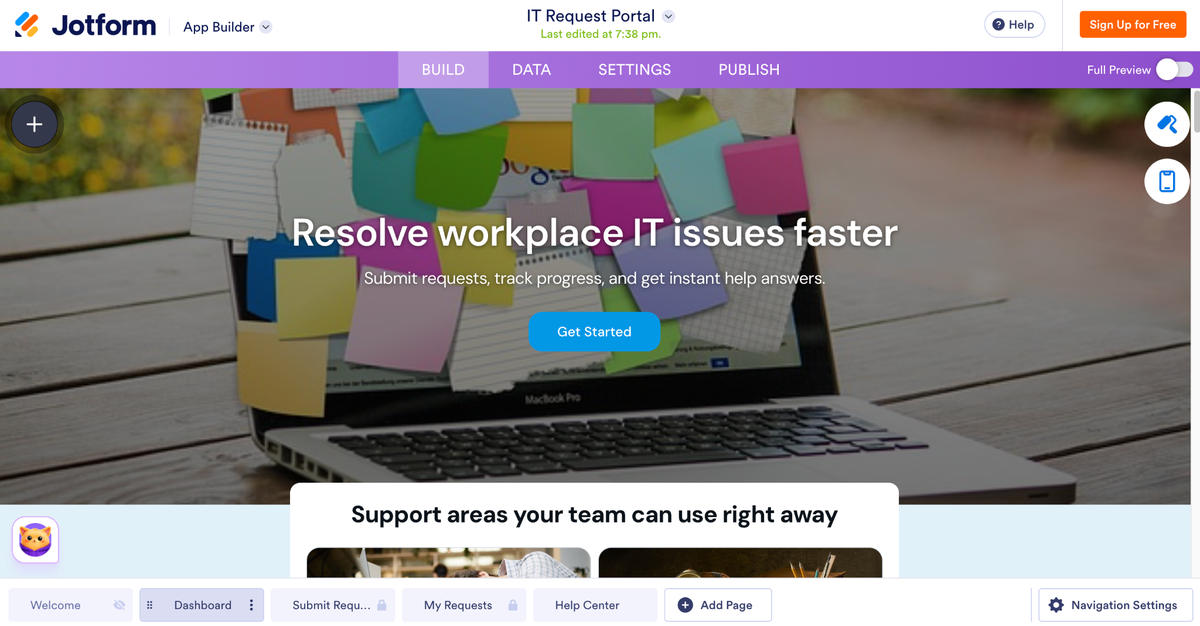
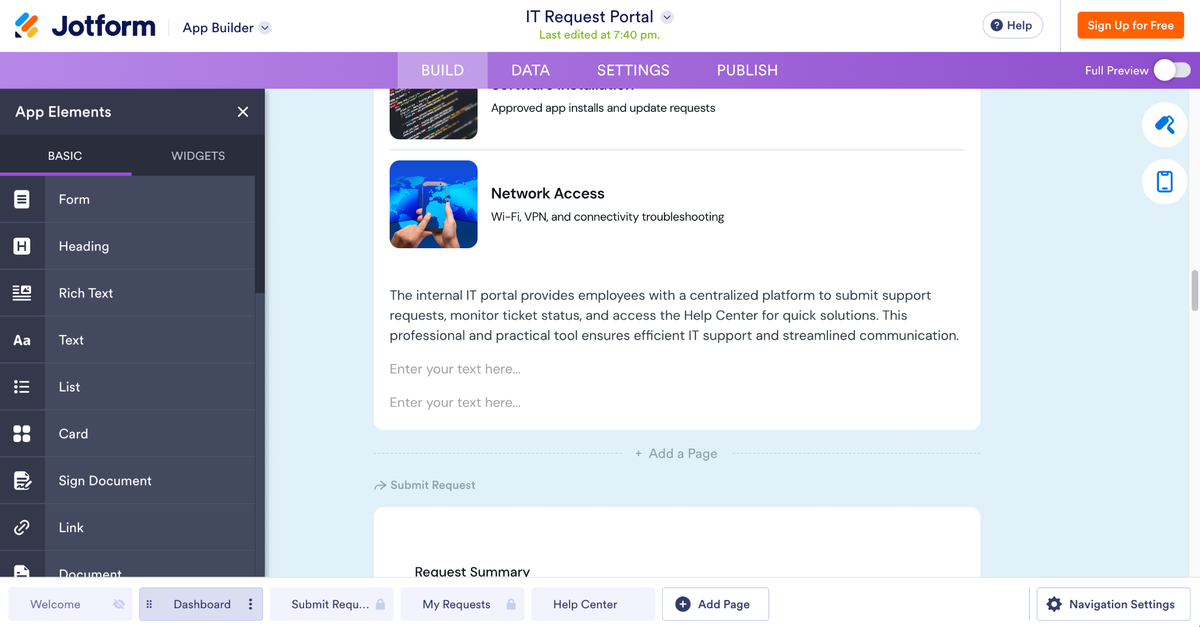
- Personnalisez l’application en ajustant la mise en page, en ajoutant votre image de marque et en modifiant le contenu, soit en sollicitant l’IA, soit en éditant directement.
- Publiez l’application et partagez-la via un lien ou un code QR, prête à l’emploi sur n’importe quel appareil.
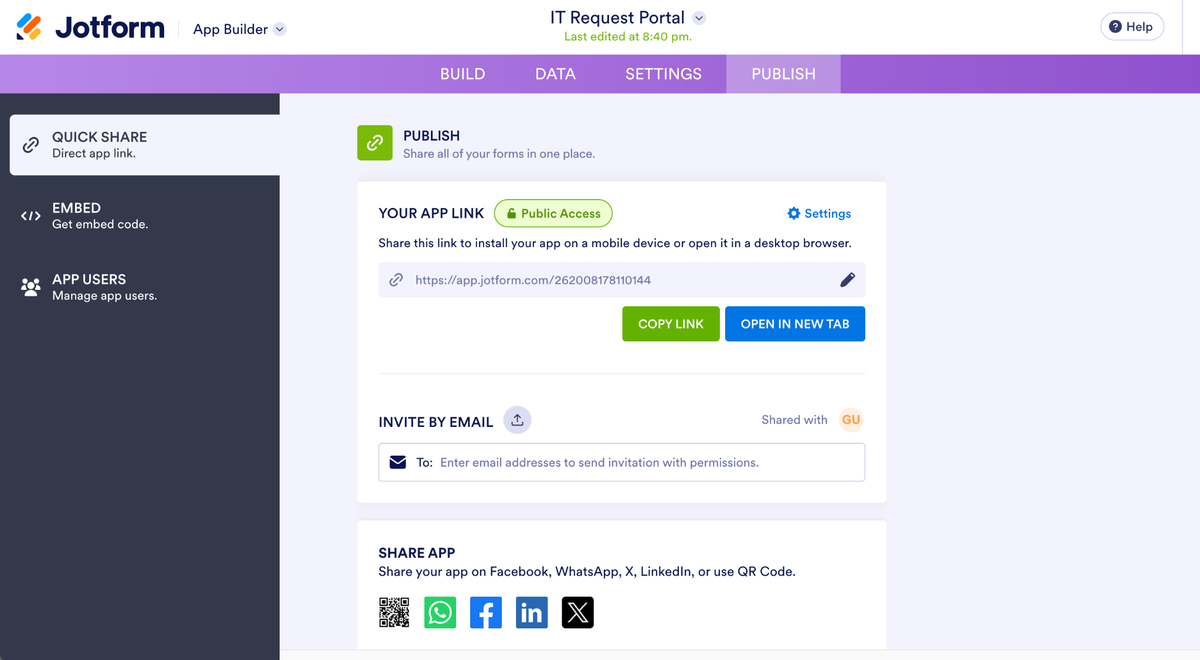
Si votre objectif était une application fonctionnelle avec des fonctionnalités d’IA, et non un projet d’ingénierie de plusieurs mois, cette approche permet de réaliser cette intégration avec un minimum de friction. Vous pouvez toujours passer à une solution sur mesure plus tard, une fois que vous savez exactement ce dont vous avez besoin.
Quelle que soit la voie que vous choisissez, les mêmes principes s’appliquent : Commencez par une première fonctionnalité réduite et ciblée, plus facile à tester qu’une fonctionnalité ouverte. Conservez votre clé API sur votre propre serveur pour protéger à la fois votre budget et vos utilisateurs. Et utilisez des sorties structurées pour empêcher votre application de planter sur une phrase qu’elle ne peut pas lire. Les limites et la journalisation que vous ajoutez avant la publication sont ce qui vous permet d’identifier les problèmes avant que quiconque ne les signale. Les gérer dès le départ coûte bien moins cher que de les intégrer après coup, une fois que les utilisateurs dépendent de la fonctionnalité.
Et si vous utilisez le générateur d’applications de Jotform, vous disposerez en quelques minutes d’une application fonctionnelle avec des fonctionnalités d’IA prête à l’emploi.
Cet article s’adresse aux directeurs techniques, aux chefs de produit et aux développeurs de logiciels qui souhaitent ajouter de l’intelligence artificielle (comme les LLM, la vision par ordinateur ou l’analyse prédictive) à leurs applications mobiles ou web existantes sans compromettre leur infrastructure actuelle.


Envoyer un commentaire: