
Die besten KI-Orchestrierungstools
KI-Orchestrierung ist die Koordinierungsebene, die Komponenten wie KI-Assistenten, Agenten und Datenpipelines miteinander verbindet, sodass diese als ein einheitliches System fungieren und komplexe Aufgaben erledigen können. Die Orchestrierungsebene legt fest, was geschieht, wann es geschieht und wo es geschieht – und stellt zudem Werkzeuge bereit, um das System während des Betriebs zu überwachen, Fehler zu beheben und betriebliche Herausforderungen zu bewältigen.
Die Lösung der Orchestrierungsebene bewirkt weit mehr als nur reibungslosere Abläufe: Sie schafft di Grundlage für autonome KI-Agenten und ermöglicht den Übergang Ihrer Infrastruktur von einem reaktiven zu einem proaktiven Ansatz. Werfen wir einen genaueren Blick darauf und erkunden einige der besten KI-Orchestrierungstools, mit denen Sie Ihre KI-Entwicklung im Jahr 2026 effizienter gestalten können.


4 Arten der KI-Orchestrierung
„Orchestrierung“ findet sich auf nahezu jeder Ebene eines KI-Stacks – doch was genau orchestriert wird, variiert stark. Wir haben diesen weit gefassten Bereich in vier Kategorien unterteilt. So lässt sich leichter erkennen, auf welche Ebene die jeweilige Plattform abzielt – was Ihnen dabei hilft, die Auswahl einzugrenzen und schnell das passende Tool zu finden.
Agenten-Orchestrierung
Agenten-Orchestrierung umfasst sämtliche Aspekte, die erforderlich sind, damit ein Agent eine Aufgabe ausführen kann. Dazu gehören die Definition von Rollen, die Steuerung des Ablaufs sowie die Festlegung der Rahmenbedingungen, unter denen die einzelnen Schritte erfolgen. Ebenfalls eingeschlossen sind Multi-Agenten-Systeme, in denen Agenten entweder gleichberechtigt zusammenarbeiten oder in einer hierarchischen Struktur agieren.
Was es orchestriert
- Welche Akteure übernehmen welche Aufgaben, in welcher Reihenfolge und unter welchen Bedingungen – einschließlich der Frage, wie Entscheidungen getroffen werden, wenn der Ablauf nicht linear verläuft
- Aufrechterhaltung eines gemeinsamen Kontexts und von Ressourcen – wie etwa Gesprächsverläufe, Werkzeugzugriffe, Datenquellen und Leitplanken (Guardrails) –, auf die Agenten einheitlich zurückgreifen.
RAG orchestration
Orchestrierungstools für Retrieval-Augmented Generation (RAG) verwalte die Pipeline, die Ihre Wissensbasis aufbereitet und zur Laufzeit gezielt abfragt – so stellen Sie sicher, dass Ihre Agenten fundierte und präzise Antworten generieren. Diese Tools bieten Ihnen die Kontrolle über beide Phasen: von der Datenaufnahme und Indizierung bis hin zur Abfrageverarbeitung und dem Abruf der Informationen.
Was es orchestriert
- Wissensaufbereitung, einschließlich des Einlesens von Dokumenten, der Textextraktion, der Unterteilung in Textabschnitte (Chunking) sowie der Erstellung durchsuchbarer Indizes/Embeddings
- Abruf und Generierung zur Laufzeit – einschließlich der Verarbeitung der Nutzerfrage, des Abrufs und der Gewichtung relevanter Inhalte, der Zusammenstellung des Prompt-Kontexts sowie der Generierung einer fundierten Antwort.
Workflow-Orchestrierung
Workflow-Orchestrierungsplattformen verwandeln unzuverlässige oder inkonsistente End-to-End-Prozesse in Abläufe, die jedes Mal auf die gleiche Weise ausgeführt werden; sie verwalten Abhängigkeiten, überwachen Fehler und bieten einfache Möglichkeiten für erneute Ausführungen oder die nachträgliche Verarbeitung fehlender Daten.
Was es orchestriert
- Aufgabenabfolge und Abhängigkeiten – die Reihenfolge der Schritte, was zuerst ausgeführt werden muss und wo Aufgaben parallel ablaufen können
- Übergaben, Datenfluss und Ausführungsregeln – einschließlich der Art und Weise, wie Daten und Ergebnisse zwischen Systemen übertragen werden, sowie der Bedingungen, Wiederholungsversuche und Ausnahmefälle, die den reibungslosen Ablauf des Workflows gewährleisten.
Cloud-Orchestrierung
KI-Plattformen für Cloud-Orchestrierung ermöglichen es Ihnen, Agenten in Ihrer Cloud-Infrastruktur zu erstellen, bereitzustellen und zu verwalten. Sie erhalten direkten Zugriff auf Ihre Daten und Dienste, wobei ein Identitäts- und Zugriffsmanagement (IAM) bereits integriert ist – so gelangen Sie ohne zusätzlichen Einrichtungsaufwand von der ersten Idee bis zum einsatzbereiten Agenten.
Was es orchestriert
- Ressourcenbereitstellung und -konfiguration – Rechen-, Speicher-, Netzwerk- und Sicherheitskomponenten in Ihrer Cloud-Umgebung werden automatisch verwaltet, damit Sie sich auf den Aufbau konzentrieren können.
- Bereitstellung und Verwaltung von Agenten, einschließlich Schnellstart-Optionen zum Erstellen, Implementieren und Skalieren von Agenten unter Nutzung Ihrer bestehenden Cloud-Dienste und Berechtigungen – ganz ohne manuelle Infrastrukturverwaltung.
Die 8 besten KI-Orchestrierungstools für Entwickler
| Werkzeug | Category | Best for | Deployment |
|---|---|---|---|
 LangGraph |
Agenten-Orchestrierung |
Zustandsbehaftete, steuerbare Agenten-Workflows (Graphen mit Verzweigungen/Schleifen, langlaufende Prozesse, Muster nach Art von Checkpointing) – für Fälle, in denen Sie eine explizite Kontrolle über die Schritte und den Zustand des Agenten benötigen. |
|
 CrewAI |
Agenten-Orchestrierung |
Rollenbasierte Multi-Agenten-Zusammenarbeit (Teams aus „Agenten“ mit Aufgaben/Rollen) – insbesondere dann, wenn eine Metapher in Form eines „Organigramms“ gewünscht ist und schnell Prototypen für Multi-Agenten-Systeme erstellt werden sollen. |
|
 LlamaIndex |
RAG-Orchestrierung |
RAG-Anwendungen und „Dokument-zu-Antwort“-Systeme mit leistungsstarken Abstraktionen für Ingestion, Chunking und Retrieval; lassen sich hervorragend mit einer Vielzahl von Datenquellen und Vektordatenbanken kombinieren. |
|
 Haystack |
RAG-Orchestrierung |
RAG-Pipelines für den produktiven Einsatz (Komponenten-/Pipeline-Ansatz), bei denen ein flexibler Graph aus Retrievern, Rankern und Generatoren sowie robuste Bereitstellungsmuster gefragt sind. |
|
 Präfekt |
Workflow-Orchestrierung |
Moderne Python-Workflows und Scheduling für Daten-/KI-Pipelines (inkl. Wiederholungsversuchen, Caching und Observability) – mit einer angenehmeren Entwicklererfahrung als bei „klassischen Schedulern“. |
|
 Apache Airflow |
Workflow-Orchestrierung |
Geplante Batch-Orchestrierung (DAG-basierte ETL-/ELT-Prozesse, wiederkehrende Jobs) mit einem riesigen Ökosystem und „Industriestandard“-Mustern |
|
 Amazon Bedrock |
Cloud-Orchestrierung |
AWS-native Plattform bzw. Orchestrierung für generative KI – für den Fall, dass Sie einen verwalteten Modellzugriff, AWS-Sicherheit und -Governance sowie eine enge Integration in AWS-Dienste benötigen. |
|
 Google Vertex AI Agent Builder |
Cloud-Orchestrierung |
GCP-native Entwicklung und Governance von Agenten (insbesondere für Unternehmen, die bereits Google Cloud nutzen) sowie Bereitstellung von Agenten mittels verwalteter Infrastruktur |
|
1. LangGraph: Am besten geeignet für komplexe, zustandsbehaftete Agenten-Ablaufsteuerungen
In einer idealen Welt funktioniert ein KI-gestütztes Kundensupport-System völlig fehlerfrei. In der Realität unterstützen dich die Funktionen von LangGraph zur Verwaltung von Status und Kontrollfluss dabei, Systeme zu entwickeln, weiterzuentwickeln und Probleme zu beheben – so kannst du neue Versionen schneller bereitstellen und Fehler zügiger korrigieren.
Das Besondere hierbei ist ein Zustand, den Sie mithilfe von Feldern definieren; diese Felder speichern Eingaben, Ausgaben sowie alle weiteren Daten, die zur Erledigung einer Aufgabe erforderlich sind. Der Zustand wird entlang des Graphen weitergereicht, wobei kontinuierlich neue Daten in ihn einfließen, bis die Aufgabe abgeschlossen ist.
Beim Debuggen liefert bereits ein Blick auf den Status wertvolle Hinweise darauf, an welcher Stelle der Ablauf fehlgeschlagen ist – doch wenn Sie Checkpointing aktivieren, zeichnet LangGraph jeden einzelnen Schritt und jede Aktion in einer Datenbank auf. Dies dient nicht nur dem Debugging: Sie können damit auch zu einem bestimmten Zeitpunkt zurückkehren, den Ablauf Schritt für Schritt nachvollziehen oder sogar einen früheren Durchlauf auf einer neuen Architektur erneut ausführen.
Das Framework ist modular aufgebaut; das bedeutet, dass Sie Datenintegrationen, LLMs oder externe APIs problemlos hinzufügen, entfernen oder anpassen können, ohne den Orchestrierungsablauf bearbeiten zu müssen. Mit LangChain für die Arbeit mit LLMs sowie LangSmith für Evaluierungen und Observability steht Ihnen zudem ein umfassendes Gesamtpaket zur Verfügung – für die gezielte Steuerung von Modellen, flexible Orchestrierung und die Etablierung einer Feedbackschleife.
- Vorteile
- Arbeitsabläufe an einem beliebigen Punkt unterbrechen und fortsetzen – ohne Daten- oder Funktionsverlust.
- an beliebiger Stelle auf einfache Weise menschliche Eingriffe (Human-in-the-Loop) einfügen
- explizite Ablaufsteuerung durch die Definition von Knoten, Verbindungen zwischen diesen sowie bedingter Routenführung
- Nachteile
- Für Personen, die an eher konventionelle, auf Pipelines basierende Denkmodelle gewöhnt sind, können zustands- und graphbasierte Ansätze zunächst kontraintuitiv wirken; insbesondere die Verwaltung von Checkpoint-Daten sowie der Umgang mit Unterbrechungen stellen dabei erhebliche Herausforderungen dar.
- Pläne/Preise
- Open Source, selbst hostbar
- Kostenloser Tarif verfügbar (5.000 Basistraces, ein Agent Builder und 50 Ausführungen pro Monat)
- Der Plus-Tarif kostet 39 $ pro Nutzer und Monat (10.000 Basis-Traces, unbegrenzte Agent-Builder sowie 500 Ausführungen pro Monat); bei Überschreitung der Tariflimits greift ein nutzungsbasiertes Abrechnungsmodell.
- Es sind auch Enterprise-Optionen verfügbar.
2. CrewAI: Am besten geeignet für rollenbasierte Zusammenarbeit mehrerer Agenten
Der Name sagt es bereits: Bei CrewAI geht es darum, ein Team aus KI-Agenten zusammenzustellen. Im Kern handelt es sich um ein Multi-Agenten-System, dessen Logik der eines menschlichen Unternehmens gleicht: Agenten verfügen über bestimmte Rollen und Fähigkeiten, und es gibt Aufgaben, die erledigt werden müssen. Sie legen fest, wer welche Aufgabe übernimmt, wie die Kontexte der Aufgaben miteinander verknüpft sind und welche Anforderungen dabei zu berücksichtigen sind.
Die Agentenklasse akzeptiert eine Rolle, ein Ziel und eine Hintergrundgeschichte, die als Systemanweisungen dienen. Agenten können auch mit Werkzeugen ausgestattet werden, sodass sie im Internet suchen, interne Wissensdatenbanken durchsuchen oder mit anderen externen Systemen interagieren können. Sie können Ihre Agenten auch so gestalten, dass sie domänenspezifische Experten sind, sodass jeder eine hochspezialisierte Implementierung von vertikaler KI sein kann.
Zudem umfassen Aufgaben eine Beschreibung sowie ein erwartetes Ergebnis – also eine Reihe von Anforderungen, die definieren, wann die Aufgabe als erledigt gilt. Diese Anforderungen werden in einfacher, verständlicher Sprache formuliert, ähnlich wie bei einem Prompt, den ein Nutzer in einen Chatbot eingeben würde. Aufgaben können zudem mit spezifischen Tools verknüpft werden – alternativ zur Zuweisung an bestimmte Agents. Besonders wichtig ist jedoch, dass Aufgaben auf den Kontext vorangegangener Aufgaben zurückgreifen können; so bauen die einzelnen Schritte aufeinander auf, während der Prozess kontinuierlich weiterläuft.
Beim Zusammenführen der Komponenten innerhalb der „Crew“-Funktion listen Sie alle verfügbaren Agenten sowie die zu erledigenden Aufgaben auf. Hier können Sie Agenten bestimmten Aufgaben zuweisen und die Reihenfolge festlegen, in der diese ausgeführt werden sollen. Sobald Sie den Prozess starten, beginnt Ihr Multi-Agenten-System mit der ersten Aufgabe und dem zugehörigen Agenten; der Ablauf setzt sich dann fort, bis das gewünschte Ergebnis vorliegt.
Der Kontrollfluss ist zwar intuitiv, aber nicht so leistungsfähig wie bei anderen Alternativen – doch das ist dem Team von CrewAI bewusst. Sie haben „Flows“ entwickelt – eine mächtigere Routing-Funktion für Fälle, in denen die Flexibilität von Multi-Agenten-Systemen mit strukturierteren, schrittweisen Abläufen kombiniert werden soll.
- Vorteile
- Multi-Agenten-Workflows lassen sich schnell und einfach prototypisch umsetzen.
- hervorragendes integriertes Tracing und Observability
- Zwei Orchestrierungsebenen in einer Plattform: Aufgabe/Rolle sowie Routing/Verzweigung
- Nachteile
- Weniger geeignet für die Erstellung von Single-Agent- und agentenbasierten Systemen oder für Anwendungsfälle, die eine präzisere Steuerung von Zuständen und Kontrollflüssen erfordern.
- Pläne/Preise
- Open Source
- In der gehosteten Variante ist ein kostenloser Tarif verfügbar, der 50 Ausführungen pro Monat sowie eine visuelle Benutzeroberfläche und einen Copiloten umfasst.
- Der „Professional“-Tarif für 25 $ pro Monat erhöht das Limit auf 100 Workflow-Ausführungen pro Monat und umfasst einen zusätzlichen Nutzerzugang sowie Zugriff auf das Community-Forum.
- Es sind auch Enterprise-Tarife verfügbar.
3. LlamaIndex: Bestes KI-Orchestrierungstool für RAG
Auf dem Papier wirkt RAG simpel – bis man ein Frage-Antwort-System entwickelt, das mit einer Vielzahl hochgradig ähnlicher, teils widersprüchlicher Daten aus Dutzenden von Dateiformaten umgehen muss. LlamaIndex gestaltet dies in der Praxis so einfach wie möglich: Es bietet leistungsstarke Grundbausteine für die Datenaufnahme, das Zerlegen in Abschnitte (Chunking) und Einbetten (Embedding) sowie für den Abruf – ergänzt durch exzellente Werkzeuge zur Datenextraktion.
Verbinden Sie zunächst Ihre Datenquellen mit LlamaParse – einer Plattform zur Dokumentenanalyse, mit der sich Dokumente in Formate umwandeln lassen, die für LLMs (Large Language Models) geeignet sind. Während die Daten in das System einfließen, werden sie in Abschnitte unterteilt, in sogenannten „Nodes“ gespeichert und mit Metadaten versehen. Für komplexere PDF-Dateien steht eine KI-Agenten-Funktion zur Verfügung: Sie nutzt Modelle wie Gemini, um die Dateien zu analysieren, die darin enthaltenen Daten zu extrahieren und diese möglichst präzise zu speichern.
Sobald Dokumente eingelesen, Embeddings gespeichert und Indizes einsatzbereit sind, geht es an den Abrufprozess (Retrieval). Die bloße Anpassung des „top-k“-Werts reicht meist nicht aus; daher bietet LlamaIndex zahlreiche Steuerungsmöglichkeiten: Sie können Ergebnisse neu gewichten (Reranking), Duplikate entfernen, filtern, eine zeitliche Gewichtung (Recency Bias) anwenden oder andere Metadaten der Datenknoten nutzen, um die passenden Textabschnitte auszuwählen. Sollten die Ergebnisse während eines Chats nicht den Richtlinien oder Compliance-Vorgaben entsprechen, lässt sich das System so konfigurieren, dass der RAG-Prozess automatisch erneut durchlaufen wird, bis eine akzeptable Antwort vorliegt.
Der Einsatz von LlamaIndex schafft keine neuen Angriffsvektoren im Hinblick auf Datenschutz oder Sicherheit – zumindest nicht mehr, als dies bei der Verwendung von Bibliotheken ohnehin der Fall ist. Dennoch hängt das Sicherheitsniveau davon ab, wie Ihre Daten verarbeitet werden und mit welchen Systemen sie während der Übertragung zwischen verschiedenen Diensten in Kontakt kommen. Da der Schwerpunkt auf RAG (Retrieval-Augmented Generation) liegt, bieten zwar auch Funktionen für den Aufruf von Tools (Tool-Calling) sowie allgemeine Arbeitsabläufe Unterstützung, doch erreichen diese möglicherweise nicht die Leistungsfähigkeit oder Flexibilität spezialisierterer Frameworks.
- Vorteile
- Ermöglicht die schnelle Erstellung eines RAG-Systems für Frage-Antwort-Szenarien, Chats und Agenten.
- robuste Datenanalyse für unsaubere Datenquellen
- erweiterte Funktionen zur Steuerung des Abrufs
- Nachteile
- Eingeschränkte Funktionen zur Steuerung des Orchestrierungsablaufs
- Der Parser ist leistungsfähig, doch ob man ihn tatsächlich nutzen kann, hängt davon ab, ob er den eigenen Richtlinien entspricht – das sollte vor einer verbindlichen Entscheidung geprüft werden.
- Pläne/Preise
- Open Source, selbst hostbar
- Verwaltete LlamaParse- und LlamaCloud-Dienste sind im Rahmen eines kostenlosen Tarifs mit 10.000 Credits verfügbar.
- Der Starter-Tarif für 50 $ pro Monat umfasst 40.000 Credits.
4. Haystack: Am besten geeignet für modulare RAG-Pipelines im produktionsreifen Einsatz
Haystack betrachtet die KI-Orchestrierung wie ein technisches Framework. Das Kernkonzept ist eine Pipeline in Form eines gerichteten Multigraphen: Man verknüpft typisierte Komponenten – etwa Retriever, Ranker oder Prompt-Builder – miteinander. Da diese Komponenten über benannte Eingangs- und Ausgangsschnittstellen verfügen, kann Haystack die Datentypen bei der Verbindung validieren. Dies erleichtert das Debugging während der Entwicklung – besonders dann, wenn die Komplexität des Projekts zunimmt oder wenn man im Team arbeitet.
Der Grund, warum es sich so gut für RAG eignet, liegt darin, dass es von Haus aus dichte (dense), dünnbesetzte (sparse) und hybride Retrieval-Verfahren bietet – ergänzt durch einen Leitfaden zur Auswahl des passenden Rankers. Sie können Ihr Setup flexibel an die spezifischen Anforderungen Ihres Anwendungsfalls anpassen und dabei Latenz, Datenschutz und Ergebnisvielfalt nach Bedarf ausbalancieren. Während LlamaIndex auf ein vorgegebenes, festes Framework setzt, legt Haystack alle Bausteine offen dar, sodass Sie exakt die Lösung aufbauen können, die Sie benötigen.
Die Modularität geht weit über bloße Komponententypen hinaus. Pipelines lassen sich in YAML serialisieren – so können Sie diese in Git versionieren, bearbeiten, ohne den Python-Code anzupassen, und mit einem einzigen Methodenaufruf neu laden. Was den operativen Bereich betrifft, so ist Haystack nahtlos in OpenTelemetry integriert: Sie können Traces an Tools wie Langfuse, Datadog oder SigNoz weiterleiten und so die Latenz der einzelnen Phasen innerhalb Ihrer gesamten Retrieval-Pipeline nachvollziehen.
Bei der Einrichtung von Haystack ist ein höherer Programmieraufwand erforderlich – insbesondere im Vergleich zu anderen Frameworks, die einen Großteil der technischen Verknüpfungen bereits für einen übernehmen. Doch dieser anfängliche Mehraufwand zahlt sich aus: Sollte im Produktivbetrieb ein Fehler auftreten, wissen Sie genau, welche Komponente Sie untersuchen müssen – was die Zeit für die Fehlerbehebung verkürzt.
- Vorteile
- Hier trifft eine leistungsfähige Ablaufsteuerung auf RAG; das Pipeline-Konzept – mit seinen klar definierten Komponenten und Verbindungen – vereinfacht das Debugging sowie das Deployment und erweist sich zudem als stabiler im Vergleich zu anderen, sich schneller weiterentwickelnden Alternativen.
- Nachteile
- Längere Einrichtungszeit im Vergleich zu anderen Frameworks
- Mehr bewegliche Teile führen zu mehr Entscheidungen – was nachteilig sein kann, wenn man ab Werk solide Standardeinstellungen bevorzugt.
- Pläne/Preise
- Open Source, selbst hostbar
- Gehostete Optionen über die deepset AI-Plattform sind für bis zu 100 Pipeline-Stunden kostenlos.
- Enterprise-Tarife mit individueller Preisgestaltung und Kontingenten sind verfügbar.
5. Prefect: Optimal für die Orchestrierung von Daten- und KI-Workflows in Python
Wenn Sie Ihre Skripte manuell ausführen, können Sie sich – notfalls durch wiederholte Versuche – zum Ziel durchschlagen, selbst wenn das bedeutet, dass Sie Jobs nach einem Timeout oder einem gelegentlichen 500-Fehler erneut starten müssen. In einer Produktionsumgebung führen jedoch Instabilitäten – etwa durch Rate-Limits oder lang laufende Prozessschritte – zu Arbeitsverlusten. Anstatt unzählige Regeln zu entwickeln, um die Eigenheiten der von Ihnen genutzten Dienste zu umgehen, operationalisiert Prefect Ihre Python-Skripte. So laufen Ihre Workflows auch dann reibungslos weiter, wenn die zugrunde liegenden Abhängigkeiten unzuverlässig sind.
Das Beste an Prefect ist, dass Sie keine neue Minisprache, kein Framework und kein komplexes Gedankenmodell erlernen müssen, um Ihren bestehenden Code damit zu ergänzen. Es gibt keine vorgegebene „Prefect-Art“, Ihre Geschäftslogik zu schreiben: Sie verwenden weiterhin ganz normale Python-Funktionen und fügen lediglich zwei Decorators hinzu – @task (für eine einzelne, nachverfolgbare Arbeitseinheit) oder @flow (für die Funktion, die die Aufgaben koordiniert). Diese decorators bieten Parameter für Wiederholungsversuche (Retries), Wartezeiten zwischen den Versuchen sowie zahlreiche weitere Konfigurationsmöglichkeiten, damit Ihr Skript genau so ausgeführt wird, wie es soll.
Der rein Python-basierte Ansatz zeigt sich zur Laufzeit: Es handelt sich weiterhin um ein Python-Skript – nun jedoch ergänzt um Zustandsverfolgung (State Tracking), Logging und Wiederholungsmechanismen (Retries), so wie Sie es im Decorator festgelegt haben. Sämtliche von Ihnen implementierten Bedingungen oder Schleifen werden direkt ausgeführt, ohne dass sie an anderer Stelle erneut deklariert werden müssen. Dies eignet sich hervorragend für KI- oder Daten-Pipelines, da der Workflow dynamisch bleiben kann, während Prefect die operativen Leitplanken bereitstellt.
Wenn Sie bereit sind, über das manuelle Ausführen von Skripten hinauszugehen, können Sie diese in eine serverseitige Repräsentation des Ablaufs (Flows) überführen. Legen Sie einen Zeitplan sowie Parameter fest und bestimmen Sie, wo der Ablauf ausgeführt werden soll. Mit Prefect lassen sich Skripte – unter anderem – über einen lokalen Prozess, einen Docker-Container oder einen Kubernetes-Job ausführen, ohne dass Sie den Code selbst anpassen müssen.
Im Vergleich zu Airflow wirkt Prefect flexibler und einfacher einzurichten. Das liegt daran, dass man alles in Python umsetzt, ohne die eigene Logik in eine umfangreiche Plattform einbetten zu müssen. Genau hier liegt jedoch auch der Kompromiss: Man trägt mehr Verantwortung für die Infrastruktur – insbesondere im Hinblick auf Worker und Work Pools.
- Vorteile
- Einfache Bereitstellung und Betrieb
- Intuitive Benutzeroberfläche, um den Überblick über das „Was, Wann und Wo“ Ihrer Workflow-Ausführungen zu behalten
- Integrierte Mechanismen für Nebenläufigkeit und Ratenbegrenzung, mit denen sich Limits über mehrere Workflows hinweg durchsetzen lassen, die gemeinsam auf APIs, GPUs oder Vektordatenbanken zugreifen.
- Nachteile
- Die Dokumentation macht das zugrunde liegende mentale Modell nicht unmittelbar deutlich; daher kann es bei der erstmaligen Einrichtung einer Produktionsumgebung schwieriger sein, die grundlegenden Zusammenhänge zu verstehen.
- Herausforderungen in mehrsprachigen, systemübergreifenden Umgebungen
- Pläne/Preise
- Open Source, selbst hostbar
- Kostenloser gehosteter Tarif für bis zu 5 Deployments mit 500 Minuten Prefect Serverless verfügbar
- Der Starter-Tarif kostet 100 $ pro Monat für 20 Deployments sowie 75 Stunden Prefect Serverless.
6. Apache Airflow: Am besten geeignet für zeitgesteuerte Pipelines und KI-Batch-Workflows
Die größte Stärke von Airflow liegt in der Bewältigung der eher unspektakulären Aspekte von KI-Produktionsumgebungen – etwa bei geplanten Feature-Pipelines, ETL-Prozessen für Inferenz-Workflows oder Batch-Jobs zur Erstellung von Embeddings. Um es gleich vorweg klarzustellen: Airflow ist nicht für die Laufzeitumgebung von Agenten ausgelegt. Wenn es in Ihrem Anwendungsfall also darum geht, mehrere LLM-Aufrufe zu koordinieren, um auf eine Anfrage zu reagieren, sollten Sie besser auf eine andere der hier aufgeführten Optionen zurückgreifen.
Sie definieren Workflows als gerichtete azyklische Graphen (Directed Acyclic Graphs, kurz DAGs), bei denen Sie die einzelnen Arbeitsschritte in Python formulieren und so festlegen, welche Aufgaben zuerst und welche anschließend ausgeführt werden sollen. Jeder dieser Graphen wird in einem bestimmten Zeitintervall ausgeführt – etwa täglich, stündlich oder in einem beliebigen anderen Rhythmus. Airflow startet die Ausführung erst nach Ablauf dieses Zeitintervalls; dies ist eine seiner wertvollsten Funktionen. Ihre Jobs arbeiten auf stabilen Datensätzen, wobei Sie nach Zeiträumen filtern können, um nachzuvollziehen, welche Daten verarbeitet wurden. Dies entspricht der gängigen Praxis bei Batch-Jobs, bei denen es beispielsweise darum geht, „die Daten der vergangenen Woche zu verarbeiten“ oder „die Daten der letzten Stunde zu bewerten“.
Es gibt zahlreiche Hilfsmittel für den Fall, dass etwas schiefgeht. Airflow bietet integrierte Funktionen, um zeitbasierte Ausführungen erneut zu starten, nachzuholen oder zu korrigieren. So lassen sich Daten nachträglich verarbeiten („Backfilling“) oder Abläufe wiederholen, falls eine Pipeline fehlschlägt oder Daten fehlen. Die Benutzeroberfläche von Airflow dient hierbei als zentrale Steuereinheit: Sie können fehlgeschlagene Tasks auswählen, deren Status zurücksetzen und sie erneut ausführen. Auch wenn sich schwerwiegende Probleme nicht auf magische Weise lösen lassen, können weniger kritische Fehler so unkompliziert behoben werden – ganz ohne zusätzlichen Programmieraufwand oder langwierige Fehlersuche.
Airflow kann weit mehr, als nur die Uhr im Blick zu behalten und Skripte zu starten: Es unterstützt auch Jobs, die datensatz- oder asset-basiert arbeiten. Das bedeutet, dass DAGs erst dann ausgelöst werden, wenn Daten tatsächlich eintreffen oder aktualisiert wurden. Sie müssen sich also nicht mehr auf vorsichtige Zeitintervalle verlassen oder darauf hoffen, dass alle Daten rechtzeitig – etwa vor 2 Uhr morgens – vorliegen.
Es ist ein so wesentlicher Bestandteil der Infrastruktur, dass nahezu alle großen Cloud-Plattformen eine eigene, verwaltete Variante anbieten – ein Beleg dafür, dass es mittlerweile zum unverzichtbaren Standard für eine zuverlässige Batch-Orchestrierung gehört. Wenn Sie Schwierigkeiten beim Datentransfer haben und zu viel Zeit mit der Fehlersuche und -behebung verbringen, bietet Ihnen Airflow ein zentrales Dashboard sowie ein Toolkit zur Fehlerbehebung, mit dem sich Probleme in Ihren Pipelines mit nur wenigen entspannten Klicks lösen lassen.
- Vorteile
- Auf eine gute Art langweilig – zuverlässig und bestens geeignet für wiederkehrende Arbeitsabläufe, die stets auf die gleiche Weise ausgeführt werden sollen.
- Die Benutzeroberfläche von Airflow dient als zentraler Einblick in den operativen Zustand und eignet sich hervorragend für die Überwachung, die Fehlersuche sowie den erneuten Anlauf von Workflows.
- ausgereift, weit verbreitet und mit einer großen Community
- Nachteile
- Es handelt sich nicht nur um Python – es ist eine komplette Plattform, was Komplexität und Wartungsaufwand mit sich bringt.
- Nicht ideal für Echtzeit- oder Streaming-Workloads
- Pläne/Preise
- Open Source, selbst hostbar
- Managed-Cloud-Dienste bei großen Anbietern können bei den Infrastrukturkosten zwischen 450 und 5.000 US-Dollar pro Monat liegen.
7. Amazon Bedrock: Am besten geeignet für AWS-native Cloud-Orchestrierung
„Bedrock“ ist eine treffende Namenswahl für diesen Amazon-Dienst: Es handelt sich um eine Steuerungsebene (Control Plane) für generative KI, die tief in das AWS-Ökosystem integriert ist. Sie nutzt Ihre bereits vorhandenen Konfigurationen und operativen Grundbausteine, um Sie bei der Entwicklung von Agenten und KI-Funktionen zu unterstützen. Das bedeutet: weniger Zeitaufwand für die Einrichtung und den Betrieb von Systemen – und mehr Zeit für die Entwicklung und Optimierung Ihrer Anwendungen, Funktionen und Pipelines.
Es bietet einen Modell-Hub mit einem umfangreichen Katalog an Basismodellen. Das Herzstück ist Claude (Amazon ist an Anthropic beteiligt); zudem stehen Modelle wie Llama, Mistral, Amazon Titan/Nova und viele weitere zur Verfügung. Anstatt sich bei jedem dieser Anbieter einzeln registrieren und anschließend Schlüssel, Kontingente sowie API-Aktualisierungen verwalten zu müssen, erfolgt die gesamte Abwicklung zentral über Bedrock. Dies erleichtert zudem A/B-Tests, da Modelle einfach ausgetauscht werden können – so lässt sich das optimale Gleichgewicht zwischen Kosten, Qualität und Latenz finden.
Bedrock bietet eine KI-native Orchestrierung über drei Werkzeuge: „Agents for Bedrock“ ermöglicht ein High-Level-Prototyping mit minimalem Programmieraufwand, wobei AWS die zugrunde liegende Logik übernimmt. „AgentCore“ bietet mehr Kontrolle und erlaubt es, ein eigenes Agenten-Framework oder individuellen Code auf einer serverlosen Infrastruktur auszuführen – inklusive Funktionen wie sitzungsübergreifender Speicherpersistenz und Observability. „Bedrock Flows“ schließlich stellt einen visuellen Workflow-Builder bereit, mit dem sich Workflows für generative KI durch das Anordnen von Knoten und Verbindungen entwerfen und implementieren lassen.
Das gesamte Nutzererlebnis ist auf AWS-native Teams ausgerichtet; wer also bereits seit Jahren in dieser Umgebung arbeitet, wird sich sofort zurechtfinden. Auch wenn die Agenten- und generativen KI-Funktionen zugunsten von Einfachheit auf ein gewisses Maß an Flexibilität verzichten, bietet Bedrock nahezu alle Möglichkeiten, um Funktionalitäten für RAG, agentenbasierte Systeme sowie Multi-Agenten-Setups zu entwickeln. Zudem sprechen der geringere Einrichtungs- und Wartungsaufwand dafür, auf Bedrock zu setzen, anstatt nach externen Alternativen zu suchen.
- Vorteile
- Bedrock lässt sich direkt in IAM integrieren – das vereinfacht die Sicherheit.
- einheitliche API für eine Vielzahl von Modellen
- Die Daten verbleiben in Ihrem AWS-Konto.
- Nachteile
- Latenzspitzen aufgrund von Multi-Tenancy; die Dokumentation ist wenig benutzerfreundlich oder nicht auf dem neuesten Stand.
- Pläne/Preise
- Nutzungsbasiert
8. Google Vertex AI Agent Builder: Am besten geeignet für GCP-native Cloud-Orchestrierung
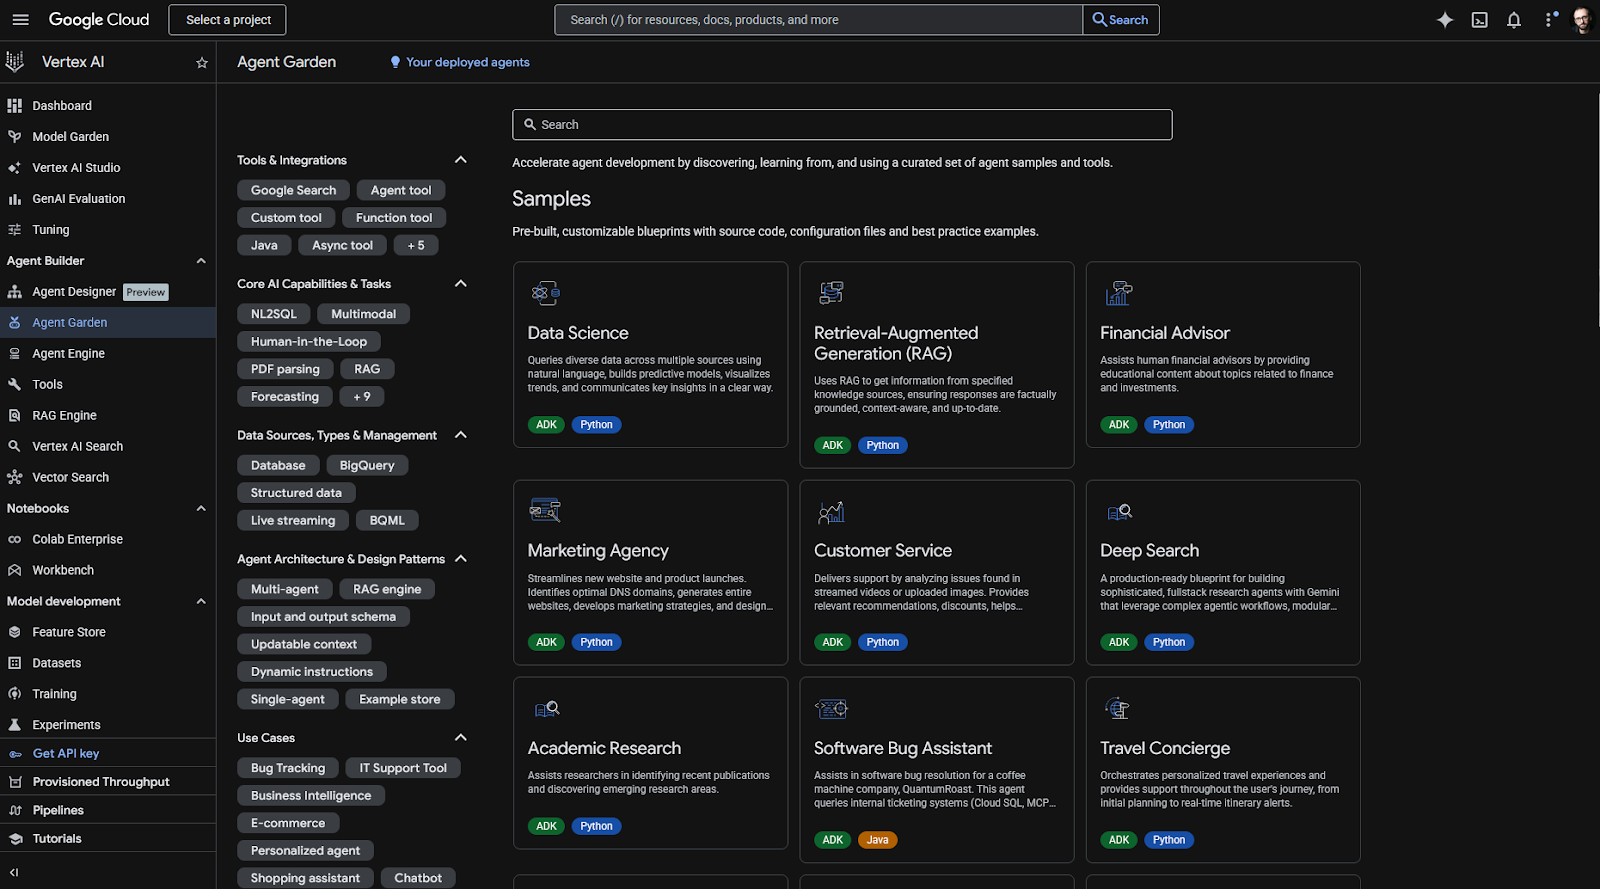
Vertex AI ist Googles Pendant zu Amazon Bedrock und bietet die gleichen Vorteile, die mit der Bereitstellung verschiedener Modelle und Orchestrierungstools auf einer Cloud-Computing-Plattform einhergehen. Dazu gehören IAM-Funktionen zur Festlegung von Berechtigungen für Modellaktionen, eine einheitliche API für den Zugriff auf jedes beliebige Modell aus dem umfangreichen Katalog sowie die nahtlose Nutzung Ihrer bereits vorhandenen Einstellungen und Daten in der Google Cloud Platform (GCP).
Was ist also anders? Nun, im „Model Garden“ von Google stehen die Gemini-Modelle im Mittelpunkt – sie zeichnen sich durch extrem große Kontextfenster, Funktionen zur Videoanalyse sowie herausragende Ergebnisse bei Intelligenz-Benchmarks aus. Insgesamt stehen über 200 Modelle zur Auswahl, darunter Llama, Mistral und Claude – das bietet Flexibilität ganz ohne Einrichtungsaufwand.
Wenn die Suchfunktion für Sie von zentraler Bedeutung ist, bietet Vertex AI zwei „Grounding“-Modi an. „Grounding mit Google Search“ verbindet Gemini direkt mit der Live-Websuchinfrastruktur von Google und liefert Suchergebnisse – inklusive Quellenangaben und Vorschlägen –, die Sie in Ihr Frontend integrieren können. Die zweite Option ist „Grounding mit Vertex AI Search“: Hier greift das System auf Ihre vorab indexierten, unternehmensinternen Daten zu und fungiert – mit minimalem Konfigurationsaufwand – als RAG-System (Retrieval-Augmented Generation). Bei Bedarf lassen sich beide Modi kombinieren; Sie können sogar das Modell selbst entscheiden lassen, welche Tools es für die jeweilige Anfrage einsetzt – so behalten Sie die Kosten besser unter Kontrolle.
Beim Erstellen von Agenten im Vertex AI Agent Builder können Sie im visuellen Low-Code-Designer beginnen – entweder von Grund auf oder auf Basis einer Vorlage. Zur Beschleunigung des Prozesses stehen einfache Konnektoren für native Tools wie BigQuery oder Google Maps zur Verfügung. Für eine detailliertere Steuerung können Sie das Agent Development Kit nutzen, mit dem sich die genaue Funktionalität bei minimalem Boilerplate-Code definieren lässt. Für komplexere Szenarien bietet das Vertex AI SDK Zugriff auf die vollständige AgentEngine-API, die eine umfassende Kontrolle ermöglicht.
Wenn sich Ihre Daten bereits in der GCP befinden, ist Vertex AI eine naheliegende Wahl – insbesondere aufgrund seiner ausgeprägten „Grounding“-Funktionen. Über dieses Ökosystem hinaus unterstützt Vertex AI Interoperabilitätsstandards wie A2A und MCP. Dadurch sind Ihre Agenten nicht an ein einzelnes Framework gebunden, was Vertex AI auch zu einer guten Option für gemischte oder Multi-Cloud-Strategien macht.
- Vorteile
- Funktionen für maschinelles Lernen – wie Prognosen, Scoring und Personalisierung – sind ebenso enthalten wie generative KI (genAI) bzw. KI-Agenten.
- Ermöglicht eine beschleunigte Überführung in die Produktion, da Agent Engine die Laufzeitumgebung, Speicherverwaltung, Skalierung sowie das Sitzungsmanagement übernimmt.
- Unterstützung für multimodale und Streaming-Funktionen bei bidirektionaler Audio- und Videoübertragung
- Nachteile
- Setzt fundierte Kenntnisse der grundlegenden GCP-Konzepte voraus; Integrationen außerhalb des Google-Ökosystems wirken wie Lösungen zweiter Klasse.
- Pläne/Preise
- Nutzungsbasiert
Wie ich diese KI-Orchestrierungstools getestet und ausgewählt habe
Ausgehend von einer Vorauswahl erweiterte ich meine Untersuchung auf 51 KI-Orchestrierungsplattformen, unterteilt in vier Kategorien: Agenten-Orchestrierung, RAG, Workflow-Automatisierung sowie Cloud-KI-Plattformen. Über einen Zeitraum von einem Monat analysierte ich die Websites und die Dokumentation der jeweiligen Plattformen; dabei berücksichtigte ich auch die Stimmung in der Entwickler-Community sowie weitere Indikatoren, die auf eine positive oder negative Tendenz hindeuten.
- Bei der Agenten-Orchestrierung habe ich den Fokus auf einfache mentale Modelle gelegt, um Single- und Multi-Agenten-Systeme auf Basis von Graphenarchitekturen zu entwickeln – ergänzt durch leistungsstarke Funktionen für Debugging und Observability.
- Im Kontext von RAG habe ich die gesamte Pipeline evaluiert – von der Dokumentenaufnahme bzw. -analyse (einschließlich verfügbarer Integrationen von Datenquellen und der Einfachheit der Anbindung) bis hin zur Frage, wie granular sich die Retrieval-Steuerung konfigurieren lässt.
- Für den Workflow waren die grundlegenden Aspekte der Operationalisierung — Wiederholungsversuche (Retries), Timeouts und Ausführungsbedingungen — die entscheidenden Kriterien. Dabei habe ich besonders auf den Aufwand für Einrichtung und Wartung geachtet.
- Im Bereich Cloud-KI habe ich die Marktbeherrschung der Plattformen mit den verfügbaren KI-Funktionsumfängen sowie der Einfachheit von Bereitstellung und Wartung abgewogen.
Jedes der in die engere Wahl gezogenen Tools wurde einem Praxistest unterzogen: Ich habe „Erste-Schritte“-Projekte umgesetzt, Umgebungen aufgesetzt und die ursprünglichen Projekte erweitert, um die für die jeweilige Plattform spezifischen Kernfunktionen zu erproben. Da es nicht realistisch war, alle Tools dem gesamten Spektrum an produktiven Herausforderungen auszusetzen, habe ich zudem offene Probleme, Community-Diskussionen und Fehlerberichte eingehend analysiert, um ein Verständnis für die jeweiligen Einschränkungen und den Umgang mit Grenz- oder Sonderfällen zu gewinnen.
Nutzen Sie Jotform AI Agents, um Ihre Arbeitsabläufe mühelos zu automatisieren.
Orchestrierungs-Pipelines sind nur so gut wie die Daten, mit denen sie gespeist werden. Bevor Ihre Agenten aktiv werden können, müssen saubere Eingabedaten erfasst werden – und genau hier kommt Jotform ins Spiel. Mit den Online-Formularen von Jotform lassen sich zuverlässige Schnittstellen zur Datenerfassung erstellen, die als Ausgangspunkt für den Start maßgeschneiderter Agenten und Abläufe (Graphen) dienen.
Jotform AI Agents geht weit über die reine Datenerfassung hinaus: Es handelt sich um eine umfassende Plattform für KI-gestützte Workflow-Automatisierung. Sie verknüpft große Sprachmodelle (LLMs) mit Wissensdatenbanken und ermöglicht den Zugriff auf externe Tools, um gezielte Aktionen in Drittsystemen auszuführen – und das alles ganz ohne Programmierung (No-Code). So können Sie – auch ohne technisches Fachwissen – schnell KI-Agenten einsetzen, die auf Basis Ihrer Daten beispielsweise den Kundensupport unterstützen oder im KI-gestützten Projektmanagement zum Einsatz kommen. Ihr Unternehmen kann auf diese Weise mit der KI-Prozessautomatisierung starten, ohne die Entwicklungsabteilungen zusätzlich zu belasten.
Dieser moderne Technologie-Stack bietet eine umfangreiche Bibliothek an Integrationen sowie Unterstützung für Webhooks. Sobald Daten erfasst wurden, können sie nachgelagerte Prozesse anstoßen – etwa die Aktualisierung einer CRM-Plattform oder das Auslösen eines Ereignisses in Ihrer Orchestrierungsebene. Durch die Einbindung von Jotform in Ihren Tech-Stack verbringen Sie weniger Zeit mit der Entwicklung von Schnittstellen und Benutzeroberflächen – und haben mehr Zeit für die Logik, auf die es wirklich ankommt.
Welcher Typ von Erbauer bist du?
Wie wählt man also das für sich passende KI-Orchestrierungstool aus? Die meisten KI-Systeme im produktiven Einsatz benötigen zwei Ebenen:
- Etwas zur Steuerung des Laufzeitverhaltens Ihrer Agenten oder Ihrer RAG-Pipeline
- Etwas, das sich einplanen, erneut ausführen und im Laufe der Zeit operationalisieren lässt
Wenn Sie zustandsbehaftete Agenten mit komplexem Kontrollfluss entwickeln, zählt LangGraph zu den besten Frameworks für die Laufzeit von KI-Agenten. Kombinieren Sie es mit Prefect für ein leichtgewichtiges Scheduling oder mit Airflow, falls Sie eine Anbindung an eine bestehende Dateninfrastruktur benötigen.
Für die Zusammenarbeit mehrerer Agenten ermöglicht CrewAI die schnelle Erstellung eines funktionierenden Prototyps. Da zudem ein Großteil der Orchestrierung im Hintergrund abgewickelt wird, ist eine separate Workflow-Ebene unter Umständen erst dann erforderlich, wenn Sie mit der Skalierung beginnen.
In RAG-Szenarien ermöglicht die auf einem festen Konzept basierende Engine von LlamaIndex eine schnellere Einrichtung; Haystack hingegen erfordert zu Beginn mehr Zeit, bietet dafür aber eine präzisere Kontrolle über die Pipeline, wenn das Projekt wächst. Beide lassen sich gut mit Prefect kombinieren.
Was die Cloud-Orchestrierung betrifft, so bedeutet die Entscheidung für AWS oder GCP, dass man Flexibilität gegen einen deutlich geringeren Einrichtungs- und Wartungsaufwand eintauscht – eine optimale Wahl für Teams, die sich nicht ständig mit der Infrastrukturseite der Agent-Laufzeitumgebung befassen möchten.
Falls es nicht sofort einleuchtet: So stellen Sie die optimale Kombination für Ihr Team zusammen – sorgen Sie zuerst für eine solide Laufzeitumgebung und integrieren Sie anschließend eine Orchestrierung für KI-Workflows, sobald Sie tatsächlich wissen, was genau Sie da eigentlich orchestrieren.
Dieser Artikel richtet sich an technisch versierte Leserinnen und Leser mit mittlerem bis fortgeschrittenem Kenntnisstand – etwa KI-/ML-Ingenieure, Entwickler, Data Engineers und Lösungsarchitekten –, die Orchestrierungs-Frameworks für Agenten, RAG-Pipelines oder die Workflow-Planung evaluieren.













Kommentar abschicken: