
Les meilleurs outils d'orchestration IA
L’orchestration IA est la couche de coordination qui relie des composants comme les assistants IA, les agents et les pipelines de données, pour qu’ils fonctionnent ensemble comme un seul système et mènent à bien des tâches complexes. C’est cette couche qui décide de ce qui se passe, à quel moment et à quel endroit. Elle offre aussi des outils pour surveiller, déboguer et gérer les problèmes opérationnels pendant que le système tourne.
Bien maîtriser cette couche d’orchestration ne se limite pas à fluidifier vos opérations : cela ouvre la voie aux agents IA autonomes et fait passer votre infrastructure d’un mode réactif à un mode proactif. Regardons cela de plus près et découvrons quelques-uns des meilleurs outils d’orchestration IA pour simplifier votre développement IA en 2026.


Les 4 types d’orchestration IA
Le terme « orchestration » revient à presque tous les niveaux d’une pile IA, mais ce qu’on orchestre réellement varie beaucoup d’un cas à l’autre. Nous avons donc divisé cette grande catégorie en quatre familles. Vous pourrez ainsi repérer le niveau que vise chaque plateforme, affiner votre choix et trouver rapidement l’outil qu’il vous faut.
L’orchestration d’agents
L’orchestration d’agents englobe tout ce qui permet à un agent de mener une tâche à son terme. Cela va de la définition des rôles à la gestion du flux de contrôle, en passant par les contraintes qui encadrent chaque étape. On y inclut aussi les configurations multi-agents, où ces derniers collaborent d’égal à égal ou s’organisent selon une hiérarchie.
Ce qu’elle orchestre
- Quels agents prennent en charge quelles tâches, dans quel ordre et sous quelles conditions, y compris la façon de décider quand le chemin n’est pas linéaire
- Le maintien d’un contexte et de ressources partagés : historiques de conversation, accès aux outils, sources de données et garde-fous auxquels tous les agents s’appuient de manière cohérente
L’orchestration RAG
Les outils d’orchestration RAG (génération augmentée par récupération) gèrent le pipeline qui prépare votre base de connaissances et l’interroge efficacement au moment de l’exécution, afin que vos agents produisent des réponses ancrées dans les faits et précises. Ces outils vous donnent la main sur les deux phases, depuis l’ingestion et l’indexation jusqu’au traitement des requêtes et à la récupération.
Ce qu’elle orchestre
- La préparation des connaissances : ingestion des documents, extraction du texte, découpage en fragments et création d’index ou d’embeddings interrogeables
- La récupération et la génération au moment de l’exécution : traitement de la question de l’utilisateur, récupération et classement du contenu pertinent, assemblage du contexte du prompt et génération d’une réponse ancrée dans les faits
L’orchestration de flux de travail
Les plateformes d’orchestration de flux de travail transforment des processus de bout en bout instables ou irréguliers en actions qui se déroulent toujours de la même manière. Elles gèrent les dépendances, surveillent les échecs et proposent des moyens simples de relancer ou de rattraper les traitements.
Ce qu’elle orchestre
- L’enchaînement des tâches et leurs dépendances : l’ordre des étapes, ce qui doit s’exécuter en premier et les tâches qui peuvent tourner en parallèle
- Les passages de relais, la circulation des données et les règles d’exécution : la façon dont les données et les résultats transitent d’un système à l’autre, ainsi que les conditions, les relances et les exceptions qui maintiennent le flux en marche
L’orchestration cloud
Les plateformes d’orchestration cloud basées sur l’IA vous permettent de créer, déployer et gérer des agents directement dans votre infrastructure cloud. Vous accédez nativement à vos données et à vos services, avec la gestion des identités et des accès (IAM) déjà intégrée. Vous passez ainsi de l’idée à l’agent opérationnel sans configuration supplémentaire.
Ce qu’elle orchestre
- Le provisionnement et la configuration des ressources : calcul, stockage, réseau et composants de sécurité de votre environnement cloud, gérés automatiquement pour que vous puissiez vous concentrer sur la création
- Le déploiement et la gestion des agents, avec des parcours de démarrage rapide pour créer, déployer et faire monter en charge vos agents à partir de vos services et autorisations cloud existants, sans gérer l’infrastructure à la main
Les 8 meilleurs outils d’orchestration IA pour les développeurs
| Outil | Catégorie | Idéal pour | Déploiement |
|---|---|---|---|
 LangGraph |
Orchestration d’agents |
Les flux de travail d’agents à états et contrôlables (graphes avec embranchements et boucles, exécutions de longue durée, modèles de type checkpointing) quand vous voulez un contrôle explicite sur les étapes et l’état de l’agent |
|
 CrewAI |
Orchestration d’agents |
La collaboration multi-agents fondée sur les rôles (des équipes d’« agents » dotés de tâches et de rôles), surtout si vous aimez la métaphore de l’« organigramme » et les prototypes multi-agents rapides |
|
 LlamaIndex |
Orchestration RAG |
Les applications RAG et les systèmes « du document à la réponse », avec de solides abstractions pour l’ingestion, le découpage et la récupération ; se marie bien avec de nombreuses sources de données et bases de données vectorielles |
|
 Haystack |
Orchestration RAG |
Les pipelines RAG en production (approche par composants et pipelines) quand vous voulez un graphe flexible de récupérateurs, de classeurs et de générateurs, avec de solides modèles de déploiement |
|
 Prefect |
Orchestration de flux de travail |
Les flux de travail Python modernes et la planification des pipelines de données et d’IA (relances, mise en cache, observabilité), avec une expérience développeur plus fluide que celle des « planificateurs classiques » |
|
 Apache Airflow |
Orchestration de flux de travail |
L’orchestration de traitements planifiés par lots (ETL/ELT basés sur des DAG, tâches récurrentes), avec un écosystème immense et des modèles considérés comme des « standards du secteur » |
|
 Amazon Bedrock |
Orchestration cloud |
La plateforme et l’orchestration d’IA générative native AWS, quand vous voulez un accès géré aux modèles, la sécurité et la gouvernance d’AWS, ainsi qu’une intégration étroite avec les services AWS |
|
 Google Vertex AI Agent Builder |
Orchestration cloud |
La création d’agents et leur gouvernance en mode natif GCP (surtout pour les entreprises déjà sur Google Cloud), ainsi que le déploiement d’agents sur une infrastructure gérée |
|
1. LangGraph : idéal pour contrôler des flux d’agents complexes et à états
Dans un monde idéal, un système de support client piloté par un agent IA tournerait sans le moindre bug ni la moindre erreur. Dans la vraie vie, les fonctionnalités de gestion d’état et de flux de contrôle de LangGraph vous aident à développer, à itérer et à résoudre les problèmes. Résultat : vous déployez de nouvelles versions plus vite et vous corrigez les erreurs plus rapidement.
L’élément vraiment particulier ici, c’est l’état que vous définissez avec des champs destinés à stocker les entrées, les sorties et tout autre type de données nécessaire pour mener une tâche à bien. Cet état circule le long du graphe, et de nouvelles données s’y ajoutent progressivement jusqu’à ce qu’il soit complet.
Au moment du débogage, un simple coup d’œil à l’état vous donne déjà de bons indices sur l’endroit où le flux a échoué. Mais si vous activez le checkpointing, LangGraph enregistre chaque étape et chaque action dans une base de données. Au-delà du débogage, vous pouvez aussi revenir à un point précis pour observer ce qui se passe étape par étape, ou même rejouer une exécution passée sur une nouvelle architecture.
Le framework est modulaire : vous pouvez facilement ajouter, retirer ou modifier des intégrations de données, des LLM ou des API externes sans toucher au flux d’orchestration. Et avec LangChain pour travailler avec les LLM, plus LangSmith pour les évaluations et l’observabilité, vous disposez d’une suite complète : contrôle personnalisé des modèles, souplesse d’orchestration et boucle de rétroaction.
- Points forts
- Interrompre et reprendre les flux de travail à n’importe quel moment, sans perdre de données ni de fonctionnalités
- Insérer facilement des interruptions avec intervention humaine à n’importe quelle étape
- Un flux de contrôle explicite, où vous déclarez les nœuds, les liens entre eux et le routage conditionnel
- Points faibles
- Raisonner en termes d’état et de graphe peut dérouter au début ceux qui sont habitués aux modèles mentaux plus classiques fondés sur les pipelines ; la gestion des données de checkpointing et des interruptions reste un vrai casse-tête
- Forfaits et tarifs
- Open source et auto-hébergeable
- Forfait gratuit disponible (5 000 traces de base, un Agent Builder et 50 exécutions par mois)
- Le forfait Plus coûte 39 $ par utilisateur et par mois (10 000 traces de base, Agent Builders illimités et 500 exécutions par mois), avec une tarification à l’usage une fois les limites du forfait dépassées
- Des offres Entreprise sont également disponibles
2. CrewAI : idéal pour le travail d’équipe multi-agents fondé sur les rôles
Tout est dans le nom : CrewAI consiste à construire votre équipe d’assistants IA. Au fond, c’est un système multi-agents qui fonctionne exactement comme une entreprise humaine : les agents ont des rôles et des compétences, et il y a des tâches à accomplir. À vous de définir qui fait quoi, comment le contexte des tâches s’articule et quelles sont les exigences à respecter.
La classe « agent » accepte un rôle, un objectif et un historique, qui tiennent lieu d’instructions système. Vous pouvez aussi rattacher des outils aux agents pour qu’ils effectuent des recherches sur le web, consultent des bases de connaissances internes ou dialoguent avec d’autres systèmes externes. Rien ne vous empêche non plus de concevoir des agents experts dans un domaine précis : chacun devient alors une mise en œuvre très ciblée de l’IA verticale.
Viennent ensuite les tâches, qui prennent une description et un résultat attendu, c’est-à-dire un ensemble de critères qui définissent ce qu’est une tâche terminée. Là encore, tout se rédige en langage courant, un peu comme un prompt que vos utilisateurs saisiraient dans un chatbot. Les tâches peuvent elles aussi recevoir des outils, si vous préférez ne pas les rattacher aux agents. Mais surtout, elles peuvent reprendre le contexte des tâches précédentes : vous continuez ainsi à bâtir sur le même fil au fur et à mesure que le flux avance.
Quand vous assemblez le tout dans la fonction « crew », vous listez l’ensemble des agents disponibles et des tâches à accomplir. C’est ici que vous reliez les agents aux tâches et que vous définissez leur ordre d’exécution. Au lancement, votre système multi-agents démarre la première tâche avec l’agent qui lui est rattaché, et le flux se poursuit jusqu’à ce que vous obteniez votre résultat.
Le flux de contrôle est intuitif, mais il reste moins robuste que dans d’autres solutions — et l’équipe de CrewAI en est consciente. Elle a développé Flows, une fonctionnalité de routage plus puissante, à utiliser quand vous devez marier la souplesse du multi-agents à des actions plus structurées, étape par étape.
- Points forts
- Facile de prototyper rapidement des flux de travail multi-agents
- Un traçage et une observabilité intégrés de grande qualité
- Deux niveaux d’orchestration réunis sur une seule plateforme : tâche/rôle et routage/branchement
- Points faibles
- Moins adapté à la création de systèmes à agent unique et de systèmes agentiques, ou à ceux qui ont besoin de fonctionnalités d’état et de flux de contrôle plus poussées
- Forfaits et tarifs
- Open source
- En version hébergée, un forfait gratuit est disponible avec 50 exécutions par mois, ainsi qu’une interface visuelle et un copilote
- Le forfait Professional, à 25 $/mois, porte la limite à 100 exécutions de flux de travail par mois, avec un utilisateur supplémentaire et l’accès au forum communautaire
- Des forfaits Entreprise sont également disponibles
3. LlamaIndex : le meilleur outil d’orchestration IA pour le RAG
Sur le papier, le RAG paraît simple — jusqu’à ce que vous conceviez un système de questions-réponses avec une masse de données très proches les unes des autres, parfois contradictoires, réparties sur des dizaines de formats de fichiers. En pratique, LlamaIndex rend la chose aussi simple que possible, grâce à de solides primitives pour l’ingestion, le découpage et l’embedding, et la récupération — le tout complété par d’excellents outils d’extraction de données.
Commencez par connecter vos sources de données à LlamaParse, une plateforme d’analyse de documents qui transforme vos fichiers dans des formats prêts à être consommés par les LLM. À mesure que vos données arrivent, elles sont découpées, enregistrées dans des nœuds et étiquetées avec des métadonnées. Pour les PDF les plus coriaces, une fonctionnalité d’assistant IA traite les fichiers à l’aide de modèles comme Gemini, afin de comprendre, d’extraire et d’enregistrer toutes les données avec le plus de précision possible.
Une fois les documents importés, les embeddings stockés et les index prêts, place à la récupération. Ajuster le top-k ne suffit jamais : c’est pourquoi LlamaIndex propose de nombreux leviers pour reclasser, dédupliquer, filtrer, privilégier les contenus récents ou s’appuyer sur n’importe quelle métadonnée de nœud afin de sélectionner les bons passages. Et si, au cours d’une conversation, les résultats ne respectent pas vos règles ou vos exigences de conformité, vous pouvez configurer le système pour relancer le flux RAG jusqu’à obtenir une réponse acceptable.
Utiliser LlamaIndex n’ajoute aucun nouveau vecteur de menace pour la confidentialité ou la sécurité de vos données — pas plus, en tout cas, que le recours à des bibliothèques. Cela dit, votre niveau de sécurité dépend toujours de la façon dont vos données circulent entre les services et des systèmes qu’elles traversent. Ici, le RAG est le cœur du sujet : vous trouverez bien un support pour l’appel d’outils et les flux de travail généraux, mais ils peuvent manquer de puissance ou de souplesse par rapport à des frameworks plus spécialisés.
- Points forts
- Permet de bâtir rapidement un système RAG pour les questions-réponses, le chat et les agents
- Une analyse robuste pour les sources de données en désordre
- Des fonctionnalités avancées pour piloter la récupération
- Points faibles
- Peu fourni côté fonctionnalités de flux de contrôle pour l’orchestration
- L’analyseur est performant, mais pour en profiter, encore faut-il qu’il respecte vos règles internes — vérifiez-le avant de vous engager
- Forfaits et tarifs
- Open source et auto-hébergeable
- LlamaParse et LlamaCloud gérés, disponibles dans un forfait gratuit avec 10 000 crédits
- Le forfait Starter, à 50 $/mois, comprend 40 000 crédits
4. Haystack : idéal pour des pipelines RAG modulaires, pensés pour la production
Haystack aborde l’orchestration IA comme un framework d’ingénierie. L’idée centrale, c’est le pipeline vu comme un multigraphe orienté : vous reliez des composants typés, comme des retrievers, des rankers ou des générateurs de prompts. Chacun déclare ses entrées et sorties nommées, ce qui permet à Haystack d’en valider les types au moment où vous les connectez. Le débogage devient d’autant plus simple à mesure que vous avancez, surtout quand la complexité du projet grimpe ou que vous travaillez en équipe.
S’il excelle pour le RAG, c’est parce qu’il propose nativement la récupération dense, éparse et hybride, le tout accompagné d’un guide de sélection des rankers. Vous adaptez votre configuration aux besoins réels de votre cas d’usage, en dosant la latence, la confidentialité et la diversité selon vos priorités. Là où LlamaIndex impose un moteur avec ses partis pris, Haystack étale toutes les pièces sur la table pour que vous construisiez exactement ce que vous voulez.
La modularité ne s’arrête pas aux types de composants. Les pipelines se sérialisent en YAML : vous pouvez les versionner dans Git, les modifier sans toucher à Python et les recharger d’un simple appel de méthode. Côté exploitation, Haystack s’instrumente proprement avec OpenTelemetry, ce qui vous permet d’envoyer vos traces vers Langfuse, Datadog ou SigNoz et de suivre la latence étape par étape sur l’ensemble de votre pipeline de récupération.
Mettre en place Haystack demande davantage de code, surtout face à d’autres frameworks qui se chargent d’une bonne partie du câblage à votre place. Mais cet effort initial finit par payer : le jour où quelque chose casse en production, vous saurez précisément quel composant examiner, et vous passerez donc moins de temps à corriger.
- Points forts
- Un contrôle de flux poussé qui rencontre le RAG ; le modèle mental du pipeline, avec ses composants et ses connecteurs, simplifie le débogage et le déploiement, et l’ensemble reste plus stable que d’autres solutions qui évoluent plus vite
- Points faibles
- Un temps de mise en place plus long que pour d’autres frameworks
- Davantage d’éléments mobiles, donc davantage de décisions à prendre, ce qui peut poser problème si vous préférez disposer de réglages par défaut solides dès le départ
- Forfaits et tarifs
- Open source et auto-hébergeable
- Des options hébergées via la plateforme deepset AI, gratuites jusqu’à 100 heures de pipeline
- Des forfaits Entreprise, avec une tarification et des quotas sur mesure, sont disponibles
5. Prefect : idéal pour orchestrer des flux de travail data et IA en Python
Quand vous lancez vos scripts à la main, vous pouvez toujours arriver au bout par la force, quitte à relancer des tâches après un délai d’attente dépassé ou une erreur 500 inattendue. Mais en production, ces instabilités liées aux limites de requêtes ou aux étapes qui s’éternisent se traduisent par du travail perdu. Plutôt que d’empiler des règles sans fin pour contourner les caprices des services que vous utilisez, Prefect met vos scripts Python en conditions d’exploitation, pour que vos flux de travail continuent d’avancer même quand les dépendances font des leurs.
Ce qu’il y a de mieux avec Prefect, c’est que vous n’avez aucun mini-langage, framework ou modèle mental compliqué à apprendre pour encapsuler votre code existant. Il n’y a pas de « méthode Prefect » pour écrire votre logique métier : vous continuez à rédiger de simples fonctions Python, en ajoutant seulement deux décorateurs pour marquer un @task (une unité de travail discrète et traçable) ou un @flow (la fonction qui orchestre les tâches). Ces décorateurs acceptent des paramètres pour les relances, le délai entre deux tentatives et bien d’autres propriétés configurables, afin de garantir que le script s’exécute comme il le doit.
Ce parti pris « tout Python » se révèle à l’exécution : il s’agit toujours d’un script Python, mais désormais doté du suivi d’état, de la journalisation et des relances que vous avez définis dans le décorateur. Les conditions et les boucles que vous écrivez s’exécutent telles quelles, sans avoir à les redéclarer ailleurs. Cela convient parfaitement aux pipelines IA et data, car le flux de travail reste dynamique pendant que Prefect gère les garde-fous opérationnels.
Quand vous êtes prêt à dépasser le lancement manuel des scripts, vous pouvez les déployer vers une représentation du flux côté serveur. Ajoutez une planification, des paramètres, puis choisissez l’endroit où le flux doit s’exécuter. Prefect vous permet de lancer vos scripts via un processus local, un conteneur Docker ou un job Kubernetes (entre autres), sans avoir à toucher au code.
Face à Airflow, Prefect paraît plus souple et plus simple à mettre en place. Et pour cause : vous faites tout en Python, sans empiler une grosse plateforme sous votre logique. Mais la contrepartie est là, elle aussi : c’est à vous que revient une plus grande part de l’infrastructure, notamment autour des workers et des pools de travail.
- Points forts
- Un déploiement et une exploitation sans prise de tête
- Une interface intuitive pour garder un œil sur le « quoi, quand et où » des exécutions de vos flux de travail
- Des primitives de concurrence et de limitation de débit intégrées, qui vous permettent d’imposer des limites sur plusieurs flux de travail partageant des API, des GPU ou des bases de données vectorielles
- Points faibles
- La documentation ne rend pas le modèle mental évident, si bien qu’il peut être plus difficile d’en saisir les bases lors d’une première mise en production
- Des difficultés dans les environnements multi-langages et inter-systèmes
- Forfaits et tarifs
- Open source et auto-hébergeable
- Un forfait gratuit hébergé, disponible jusqu’à 5 déploiements avec 500 minutes de Prefect Serverless
- Le forfait Starter, à 100 $/mois, pour 20 déploiements et 75 heures de Prefect Serverless
6. Apache Airflow : idéal pour les pipelines planifiés et les flux de travail IA par lots
Le grand atout d’Airflow, c’est sa façon de prendre en charge la partie la moins reluisante du travail de production autour de l’IA : pipelines de features planifiés, ETL vers l’inférence ou encore jobs d’embedding par lots. Soyons clairs d’emblée : il ne gère pas l’exécution d’agents. Si votre besoin consiste à coordonner plusieurs appels de LLM pour répondre à une requête, mieux vaut vous tourner vers une autre option de cette liste.
Vous définissez vos flux de travail sous forme de graphes orientés acycliques (DAG) : vous décrivez les étapes de votre job en Python, en indiquant quelles tâches passent en premier et lesquelles suivent. Chaque graphe s’exécute ensuite à intervalle régulier, que vous pouvez régler sur une base quotidienne, horaire ou toute autre fréquence. Airflow ne se déclenche qu’une fois cet intervalle écoulé, et c’est là l’un de ses meilleurs atouts. Vos jobs travaillent sur des jeux de données stables, vous pouvez filtrer par période pour retrouver les données traitées, et cela colle parfaitement à la logique des jobs par lots, souvent liés au « traitement des données de la semaine dernière » ou au « scoring de la dernière heure ».
Les outils ne manquent pas pour vous aider quand les choses tournent mal. Airflow intègre des réglages pour relancer, rattraper et réparer les exécutions planifiées, ce qui vous permet de combler les trous ou de rejouer un traitement chaque fois qu’un pipeline échoue ou que des données vous manquent. L’interface d’Airflow fait office de tableau de bord principal pour tout cela : vous sélectionnez un ensemble de tâches en échec, vous les effacez, puis vous les relancez. Elle ne résoudra pas par magie les pannes sérieuses, mais elle rend les erreurs à faible enjeu faciles à corriger, sans code supplémentaire ni longue séance de dépannage.
Airflow ne se contente pas de surveiller l’horloge et de lancer des scripts : il gère aussi des jobs sensibles aux jeux de données et aux assets. Autrement dit, il peut déclencher des DAG dès que les données arrivent ou se mettent à jour. Plus besoin d’être trop prudent sur vos intervalles ni de croiser les doigts en espérant que tout soit bien arrivé avant 2 h du matin.
Il tient une place si importante dans l’infrastructure que la quasi-totalité des grandes plateformes cloud en proposent leur propre version gérée, preuve qu’il est devenu un incontournable de l’orchestration de lots fiable. Si vous peinez à faire circuler vos données et passez trop de temps à dépanner et à corriger, Airflow vous offre un tableau de bord centralisé et une boîte à outils de récupération qui transforment la lutte contre les incidents en quelques clics tranquilles.
- Points forts
- Un côté « ennuyeux » dans le bon sens du terme : fiable et parfaitement adapté aux flux de travail répétables que vous voulez voir exécutés de façon régulière
- L’interface d’Airflow offre une vue d’ensemble sur la santé opérationnelle et excelle pour surveiller, dépanner et relancer les flux de travail
- Un outil mature, largement adopté et porté par une vaste communauté
- Points faibles
- Ce n’est pas qu’une affaire de Python : c’est toute une plateforme, ce qui s’accompagne de complexité et d’une charge de maintenance
- Pas idéal pour les charges de travail en temps réel ou en streaming
- Forfaits et tarifs
- Open source et auto-hébergeable
- Les services cloud gérés par les grands fournisseurs peuvent coûter entre 450 $ et 5 000 $/mois en frais d’infrastructure
7. Amazon Bedrock : idéal pour l’orchestration cloud native AWS
Le nom Bedrock, « socle » en anglais, est bien choisi pour ce service d’Amazon : un plan de contrôle d’IA générative profondément intégré à l’écosystème AWS, qui s’appuie sur l’ensemble de vos configurations et primitives d’exploitation existantes pour vous aider à bâtir des agents et des fonctionnalités d’IA. Résultat : moins de temps à configurer et à exploiter des systèmes, et davantage à construire et améliorer vos applications, vos fonctionnalités et vos pipelines.
Bedrock propose un hub de modèles doté d’un vaste catalogue de modèles de fondation. La vedette, c’est Claude (Amazon détient une participation dans Anthropic), mais Llama, Mistral, Amazon Titan/Nova et bien d’autres sont également disponibles. Au lieu de vous inscrire séparément chez chaque fournisseur, puis de jongler entre les clés, les quotas et les mises à jour d’API, tout se gère directement dans Bedrock. Il devient aussi plus simple de tester différentes alternatives en A/B : vous changez de modèle à la volée pour arbitrer entre coût, qualité et latence selon vos besoins.
Bedrock assure une orchestration native pour l’IA grâce à trois outils. Agents for Bedrock se charge du prototypage de haut niveau avec un minimum de code, AWS exécutant la logique en coulisses. AgentCore vous donne davantage de contrôle : vous pouvez faire tourner votre propre framework d’agents ou du code personnalisé sur une infrastructure serverless, avec des fonctionnalités comme la persistance de la mémoire entre sessions et l’observabilité. Enfin, Bedrock Flows offre un générateur de flux de travail visuel pour concevoir et mettre en place des flux d’IA générative en agençant des nœuds et des connexions.
Toute l’expérience est pensée pour les équipes rodées à AWS : si vous travaillez avec cet écosystème depuis des années, vous serez en terrain connu. Les fonctionnalités d’agents et d’IA générative sacrifient un peu de souplesse au profit de la simplicité, mais Bedrock couvre la quasi-totalité des capacités nécessaires pour développer du RAG, des systèmes agentiques et des configurations multi-agents. Et avec sa charge de configuration et de maintenance réduite, il y a de bonnes raisons de rester sur Bedrock plutôt que d’aller voir ailleurs.
- Points forts
- Bedrock se branche directement sur IAM, ce qui simplifie la sécurité
- Une API unique pour de nombreux modèles
- Vos données restent dans votre compte AWS
- Points faibles
- Des pics de latence liés à la multi-location, et une documentation ni très accessible ni toujours à jour
- Forfaits et tarifs
- Facturation à l’usage
8. Google Vertex AI Agent Builder : idéal pour l’orchestration cloud native GCP
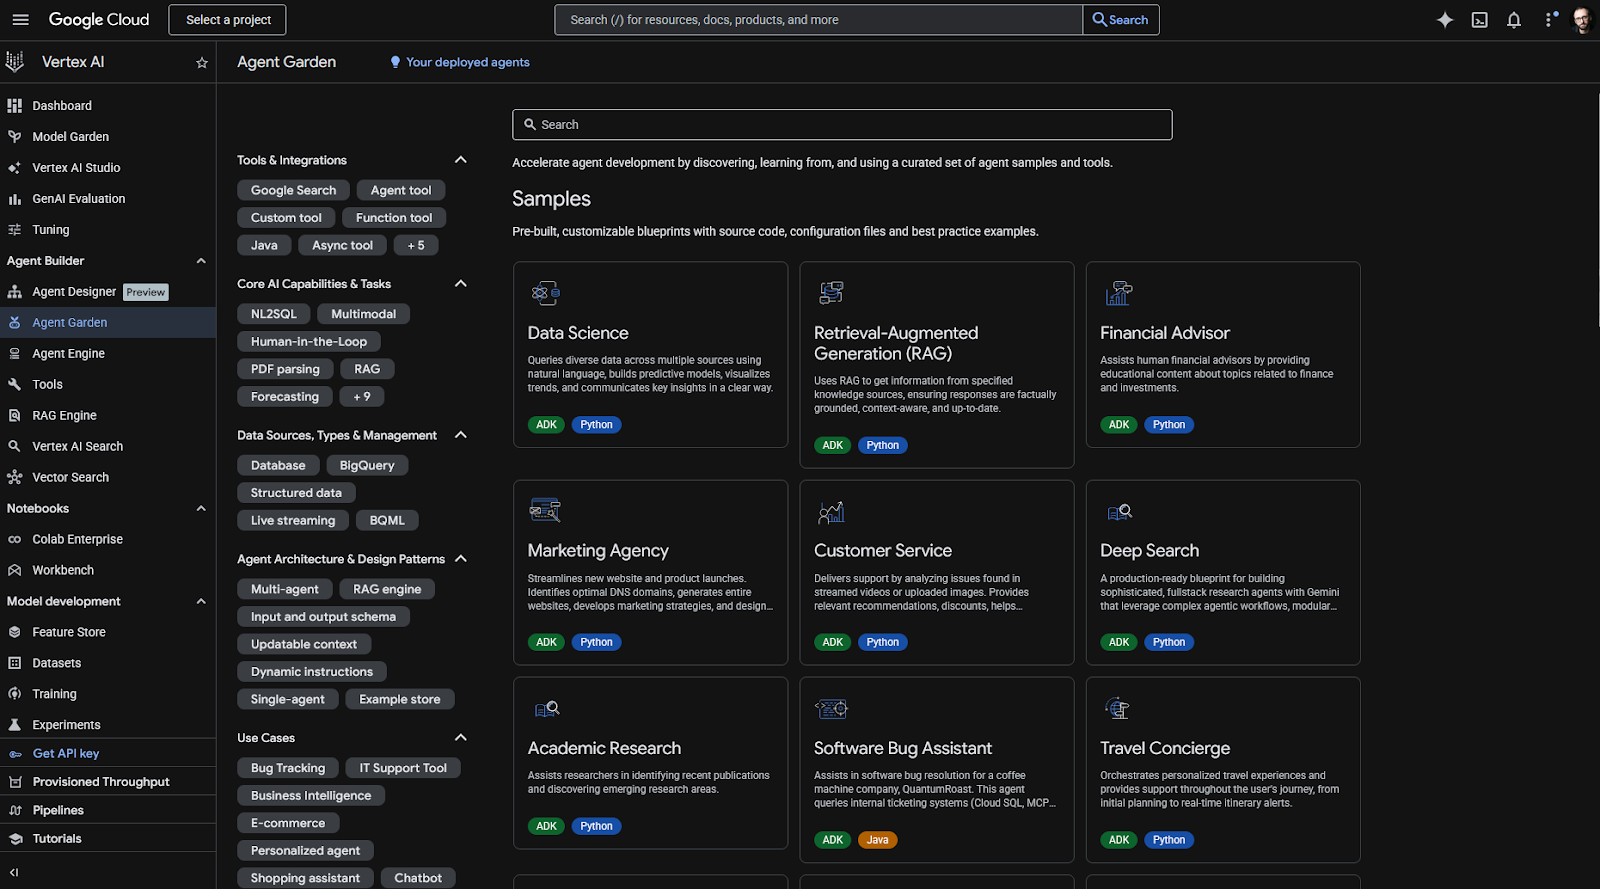
Vertex AI est la réponse de Google au Bedrock d’Amazon, avec les mêmes avantages liés au fait de réunir plusieurs modèles et outils d’orchestration au sein de votre plateforme de cloud computing. Vous disposez donc d’IAM pour définir les droits attachés aux actions des modèles, d’une API unifiée pour utiliser n’importe quel modèle de son vaste catalogue, et de la possibilité de tirer parti de tous vos réglages et données déjà présents dans GCP.
Alors, qu’est-ce qui change ? Du côté du Model Garden de Google, ce sont les modèles Gemini qui mènent la danse, avec leurs fenêtres de contexte extrêmement larges, leurs capacités de compréhension vidéo et d’excellents scores aux benchmarks d’intelligence. Plus de 200 modèles sont disponibles, dont Llama, Mistral et Claude : une vraie liberté de choix, sans la lourdeur de la configuration.
Si la recherche est au cœur de votre projet, Vertex AI propose deux modes d’ancrage. Le premier, Grounding with Google Search, relie directement Gemini à l’infrastructure de recherche web en temps réel de l’entreprise : il renvoie des résultats accompagnés de citations et de suggestions que vous pouvez intégrer côté front-end. Le second, Grounding with Vertex AI Search, plonge dans vos données d’entreprise privées pré-indexées et fonctionne comme un système RAG avec un minimum de configuration. Vous pouvez même combiner les deux modes, et laisser le modèle choisir les outils à mobiliser pour chaque requête afin de mieux maîtriser vos coûts.
Pour créer des agents dans le Vertex AI Agent Builder, vous pouvez démarrer dans l’éditeur visuel low-code, en partant de zéro ou d’un modèle. Des connecteurs prêts à l’emploi vers des outils natifs comme BigQuery ou Google Maps vous font gagner du temps. Pour un contrôle plus poussé, l’Agent Development Kit vous permet de définir le comportement exact avec un minimum de code répétitif. Et pour les scénarios avancés, le SDK Vertex AI expose l’intégralité de l’API AgentEngine, pour une maîtrise totale.
Si vos données se trouvent déjà dans GCP, Vertex AI s’impose tout naturellement, notamment pour ses solides capacités d’ancrage. Au-delà de cet écosystème, il prend en charge des standards d’interopérabilité comme A2A et MCP, si bien que vos agents ne sont pas enfermés dans un seul framework. C’est donc aussi une bonne option pour les stratégies mixtes ou multi-cloud.
- Points forts
- Des fonctionnalités de machine learning comme la prévision, le scoring et la personnalisation, en plus de l’IA générative et des agents
- Une mise en production accélérée, puisque Agent Engine gère le runtime, la mémoire, la montée en charge et les sessions
- La prise en charge du multimodal et du streaming, avec de l’audio et de la vidéo bidirectionnels
- Points faibles
- Il faut une bonne maîtrise des concepts de base de GCP pour s’en servir, et les intégrations hors Google font un peu figure de parents pauvres
- Forfaits et tarifs
- Facturation à l’usage
Comment j’ai testé et sélectionné ces outils d’orchestration IA
Partant d’une première sélection, j’ai élargi mon évaluation à 51 plateformes d’orchestration IA réparties en quatre catégories : l’orchestration d’agents, le RAG, l’automatisation des flux de travail et les plateformes d’IA cloud. Pendant un mois, j’ai décortiqué les pages web et la documentation de chaque plateforme, tout en suivant l’avis des développeurs et d’autres signaux révélateurs d’un ressenti positif ou négatif.
- Pour l’orchestration d’agents, j’ai privilégié les modèles mentaux simples permettant de construire des configurations à un ou plusieurs agents sur des architectures en graphes, avec de solides capacités de débogage et d’observabilité.
- Pour le RAG, j’ai évalué l’ensemble du pipeline, de l’ingestion et de l’analyse des documents (y compris les intégrations de sources de données disponibles et la facilité de connexion) jusqu’à la finesse des contrôles de récupération.
- Pour les flux de travail, les critères décisifs tournaient autour des fondamentaux de la mise en production : relances, délais d’expiration et conditions d’exécution. J’ai aussi gardé un œil sur la charge de configuration et de maintenance.
- Pour l’IA cloud, j’ai mis en balance la position de la plateforme sur le marché, l’étendue des fonctionnalités d’IA proposées et la simplicité de déploiement et de maintenance.
Chaque outil retenu est passé par des tests concrets : j’ai réalisé des projets de démarrage, mis en place des environnements, puis étoffé ces premiers projets pour expérimenter les fonctionnalités clés propres à chaque plateforme. Comme il m’était impossible, en pratique, de confronter tous les outils à l’ensemble des défis de la production, j’ai aussi fouillé les tickets ouverts, les discussions de la communauté et les rapports de bugs pour cerner les limites et la gestion des cas particuliers.
Automatisez vos flux de travail en toute simplicité avec les Assistants IA Jotform
Un pipeline d’orchestration ne vaut que ce que valent les données qu’on lui transmet. Avant que vos agents puissent agir, il faut bien que quelque chose recueille des entrées propres, et c’est précisément là que Jotform entre en jeu. Avec les formulaires en ligne de Jotform, vous créez des interfaces de collecte de données fiables, qui servent de point de départ pour déclencher vos agents et vos graphes personnalisés.
Mais la collecte de données n’est qu’un début. Les Assistants IA Jotform forment une véritable plateforme agentique dédiée à l’automatisation des flux de travail par l’IA : elle relie les LLM à vos bases de connaissances et déclenche des appels d’outils pour agir sur des systèmes externes, le tout dans une expérience sans code. Concrètement, vous — et vos équipes non techniques — pouvez déployer rapidement des agents qui s’appuient sur vos données pour assurer le service client ou alimenter la gestion de projet par l’IA. Votre entreprise peut ainsi se lancer dans l’automatisation des processus par l’IA sans faire exploser la charge de travail de vos développeurs.
Cette stack technique en première ligne s’accompagne d’une riche bibliothèque d’intégrations et de la prise en charge des webhooks. Une fois les données recueillies, elles peuvent enclencher des processus en aval : mettre à jour une plateforme de gestion de la relation client, par exemple, ou envoyer un événement vers votre couche d’orchestration. Ajouter Jotform à votre panoplie d’outils, c’est passer moins de temps à construire des interfaces et des expériences utilisateur, et davantage à travailler sur la logique qui compte vraiment.
Quel type de bâtisseur êtes-vous ?
Alors, comment choisir l’outil d’orchestration IA qui vous convient ? La plupart des systèmes d’IA en production reposent sur deux couches :
- Un élément pour gérer le comportement à l’exécution de vos agents ou de votre pipeline RAG
- Un élément pour planifier, relancer et faire tourner ce travail dans la durée
Si vous construisez des agents à état avec un flux de contrôle complexe, LangGraph figure parmi les meilleurs frameworks d’assistants IA côté exécution. Associez-le à Prefect pour une planification légère, ou à Airflow si vous vous branchez sur une infrastructure de données existante.
Pour la collaboration multi-agents, CrewAI vous amène très vite à un prototype fonctionnel. Il gère aussi l’essentiel de l’orchestration en coulisses : vous n’aurez sans doute pas besoin d’une couche de flux de travail distincte avant de passer à l’échelle.
Dans un contexte RAG, le moteur très cadré de LlamaIndex permet une mise en place plus rapide. Haystack, lui, est plus long à démarrer, mais vous offre un contrôle plus poussé du pipeline à mesure que vous montez en puissance. Les deux s’accordent bien avec Prefect.
Côté orchestration cloud, opter pour AWS ou GCP, c’est sacrifier un peu de flexibilité contre une charge de configuration et de maintenance nettement allégée. C’est le meilleur choix pour les équipes qui ne veulent pas se battre en permanence avec l’infrastructure de l’exécution des agents.
Si cela ne vous saute pas encore aux yeux, voici comment trouver la combinaison gagnante pour votre équipe : réglez d’abord l’exécution, puis ajoutez par-dessus l’orchestration des flux de travail IA une fois que vous savez vraiment ce que vous orchestrez.
Cet article s’adresse à un lectorat technique de niveau intermédiaire à avancé : ingénieurs IA/ML, développeurs, ingénieurs data et architectes de solutions qui évaluent des frameworks d’orchestration pour des agents, des pipelines RAG ou la planification de flux de travail.













Envoyer un commentaire: