
I migliori strumenti di orchestrazione IA
L’orchestrazione IA è lo strato di coordinamento che collega componenti come assistenti IA, agenti e pipeline di dati, in modo che funzionino come un unico sistema e portino a termine attività complesse. È questo strato a decidere cosa succede, quando e dove, offrendoti anche gli strumenti per monitorare, correggere gli errori e affrontare le sfide operative mentre il sistema è in funzione.
Risolvere lo strato di orchestrazione non significa solo far girare tutto in modo più fluido: apre la strada agli agenti IA autonomi e trasforma la tua infrastruttura da reattiva a proattiva. Vediamo da vicino alcuni dei migliori strumenti di orchestrazione IA per snellire lo sviluppo IA nel 2026.


4 tipi di orchestrazione IA
La parola «orchestrazione» spunta praticamente a ogni livello di uno stack IA, ma ciò che viene effettivamente orchestrato cambia molto da un caso all’altro. Abbiamo diviso questa categoria così ampia in quattro gruppi, per aiutarti a capire a quale livello punta ciascuna piattaforma: così restringi il campo e trovi in fretta lo strumento giusto.
Orchestrazione degli agenti
L’orchestrazione degli agenti riguarda tutto ciò che serve perché un agente porti a termine un’attività: definire i ruoli, gestire il flusso di controllo e stabilire i vincoli entro cui avviene ogni passaggio. Comprende anche le configurazioni multi-agente, in cui gli agenti collaborano come pari o lavorano secondo una gerarchia.
Cosa orchestra
- Quali agenti si occupano di quali attività, in che ordine e a quali condizioni, incluso come prendere decisioni quando il percorso non è lineare
- Il mantenimento di contesto e risorse condivisi, come lo storico delle conversazioni, l’accesso agli strumenti, le fonti di dati e i guardrail a cui tutti gli agenti attingono in modo coerente
Orchestrazione RAG
Gli strumenti di orchestrazione retrieval-augmented generation (RAG) gestiscono la pipeline che prepara la tua base di conoscenza e la interroga in modo efficace durante l’esecuzione, così i tuoi agenti generano risposte fondate e precise. Con questi strumenti controlli entrambe le fasi, dall’ingestione e indicizzazione fino all’elaborazione delle query e al recupero.
Cosa orchestra
- La preparazione della conoscenza, cioè l’ingestione dei documenti, l’estrazione del testo, la suddivisione in chunk e la creazione di indici ed embedding ricercabili
- Il recupero e la generazione in fase di esecuzione, ovvero elaborare la domanda dell’utente, recuperare e ordinare i contenuti pertinenti, comporre il contesto del prompt e generare una risposta fondata
Orchestrazione dei flussi di lavoro
Le piattaforme di orchestrazione dei flussi di lavoro trasformano processi end-to-end instabili o incostanti in azioni che si svolgono sempre allo stesso modo: gestiscono le dipendenze, tengono d’occhio gli errori e offrono modi semplici per ritentare o recuperare i dati mancanti.
Cosa orchestra
- La sequenza delle attività e le loro dipendenze: l’ordine dei passaggi, cosa deve girare per primo e dove le attività possono procedere in parallelo
- I passaggi di consegna, il flusso dei dati e le regole di esecuzione: come dati e output si spostano tra i sistemi, oltre alle condizioni, ai tentativi di ripetizione e alle eccezioni che tengono in piedi il flusso di lavoro
Orchestrazione cloud
Le piattaforme IA di orchestrazione cloud ti permettono di creare, distribuire e gestire gli agenti direttamente nella tua infrastruttura cloud. Hai accesso nativo ai tuoi dati e servizi, con la gestione di identità e accessi (IAM) già integrata, così passi dalle idee agli agenti funzionanti senza configurazioni aggiuntive.
Cosa orchestra
- Il provisioning e la configurazione delle risorse, cioè i componenti di calcolo, archiviazione, rete e sicurezza di tutto il tuo ambiente cloud, gestiti in automatico così tu puoi concentrarti sullo sviluppo
- La distribuzione e la gestione degli agenti, con percorsi rapidi per creare, distribuire e scalare gli agenti usando i servizi cloud e i permessi che hai già, senza dover gestire l’infrastruttura a mano
Gli 8 migliori strumenti di orchestrazione IA per gli sviluppatori
| Strumento | Categoria | Ideale per | Distribuzione |
|---|---|---|---|
 LangGraph |
Orchestrazione degli agenti |
Flussi di lavoro di agenti stateful e controllabili (grafi con ramificazioni e cicli, esecuzioni a lunga durata, pattern in stile checkpointing) quando vuoi un controllo esplicito sui passaggi e sullo stato dell’agente |
|
 CrewAI |
Orchestrazione degli agenti |
Collaborazione multi-agente basata sui ruoli (team di «agenti» con attività e ruoli), soprattutto quando ti serve la metafora dell’«organigramma» e vuoi prototipi multi-agente rapidi |
|
 LlamaIndex |
Orchestrazione RAG |
App RAG e sistemi «dal documento alla risposta», con solide astrazioni per ingestione, suddivisione in chunk e recupero; si abbina bene a molte fonti di dati e database vettoriali |
|
 Haystack |
Orchestrazione RAG |
Pipeline RAG in produzione (con un approccio a componenti e pipeline), quando vuoi un grafo flessibile di retriever, ranker e generatori e solidi pattern di distribuzione |
|
 Prefect |
Orchestrazione dei flussi di lavoro |
Flussi di lavoro Python moderni e pianificazione per pipeline di dati e IA (ripetizioni, caching, osservabilità), con un’esperienza per sviluppatori più fluida rispetto agli «scheduler classici» |
|
 Apache Airflow |
Orchestrazione dei flussi di lavoro |
Orchestrazione di batch pianificati (ETL/ELT basato su DAG, job ricorrenti) con un ecosistema enorme e pattern ormai «standard del settore» |
|
 Amazon Bedrock |
Orchestrazione cloud |
Piattaforma e orchestrazione di genAI native su AWS, quando vuoi accesso gestito ai modelli, la sicurezza e la governance di AWS e un’integrazione stretta con i servizi AWS |
|
 Google Vertex AI Agent Builder |
Orchestrazione cloud |
Creazione e governance di agenti native su GCP (in particolare per le aziende già su Google Cloud) e distribuzione degli agenti con infrastruttura gestita |
|
1. LangGraph: ideale per il controllo del flusso di agenti complessi e stateful
In un mondo ideale, un sistema di assistenza clienti basato su agenti IA funziona senza bug né errori. Nella realtà, le funzioni di gestione dello stato e del flusso di controllo di LangGraph ti aiutano a sviluppare, iterare e risolvere i problemi: così distribuisci nuove versioni più in fretta e correggi gli errori più in fretta.
L’elemento che fa la differenza è uno stato che definisci tu, con campi per memorizzare input, output e qualsiasi altro tipo di dato ti serva per portare a termine un’attività. Questo stato viene passato lungo il grafo e, man mano, i nuovi dati vi confluiscono fino a completare il lavoro.
Durante il debug, basta guardare lo stato per capire dove il flusso è andato storto. E se attivi il checkpointing, LangGraph registra in un database ogni singolo passaggio e ogni azione. Oltre al debug, questo ti permette di tornare indietro a un punto preciso, così puoi osservare cosa succede passo dopo passo o anche riprovare un’esecuzione passata su una nuova architettura.
Il framework è modulare: puoi aggiungere, rimuovere o cambiare con facilità le integrazioni dei dati, gli LLM o le API esterne senza toccare il flusso di orchestrazione. E con LangChain per lavorare con gli LLM e LangSmith per valutazioni e osservabilità, hai una suite completa per il controllo personalizzato dei modelli, la flessibilità dell’orchestrazione e un ciclo di feedback.
- Vantaggi
- Interrompi e riprendi i flussi di lavoro in qualsiasi momento, senza perdere dati o funzionalità
- inserisci facilmente interruzioni con l’intervento umano in qualsiasi punto
- flusso di controllo esplicito, dichiarando i nodi, gli archi che li collegano e l’instradamento condizionale
- Svantaggi
- Ragionare in termini di stato e grafo all’inizio può risultare poco intuitivo per chi è abituato ai modelli mentali più classici basati su pipeline; gestire i dati di checkpointing e le interruzioni sono i punti più ostici
- Piani e prezzi
- Open source, ospitabile in autonomia
- è disponibile un piano gratuito (5.000 trace di base, un Agent Builder e 50 esecuzioni al mese)
- il piano Plus costa 39 dollari per postazione al mese (10.000 trace di base, Agent Builder illimitati e 500 esecuzioni al mese), con tariffazione a consumo una volta superati i limiti del piano
- sono disponibili anche opzioni enterprise
2. CrewAI: ideale per il lavoro di squadra multi-agente basato sui ruoli
Lo dice già il nome: CrewAI ti serve a costruire la tua «squadra» (crew) di assistenti IA. È un sistema multi-agente a tutti gli effetti, e la logica è la stessa di un’azienda fatta di persone: gli agenti hanno ruoli e capacità, e ci sono attività da portare a termine. Sei tu a definire chi fa cosa, come si collega il contesto delle attività e quali requisiti sono in gioco.
La classe dell’agente accetta un ruolo, un obiettivo e una storia di base, che fanno da istruzioni di sistema. Agli agenti puoi collegare anche degli strumenti, così possono cercare sul web, consultare le basi di conoscenza interne o interagire con altri sistemi esterni. Puoi inoltre costruire agenti specializzati per un determinato ambito, in modo che ciascuno sia un’implementazione mirata di IA verticale.
Le attività, poi, accettano una descrizione e un output atteso: l’insieme dei requisiti che stabiliscono quando sono da considerarsi concluse. Anche questi si scrivono in linguaggio naturale, proprio come un prompt che i tuoi utenti scriverebbero in un chatbot. Alle attività puoi collegare degli strumenti, se preferisci non assegnarli agli agenti, ma soprattutto possono ereditare il contesto delle attività precedenti: così continui a costruire sullo stesso filo man mano che il flusso avanza.
Quando colleghi tutto nella funzione crew, elenchi tutti gli agenti disponibili e le attività da completare. È qui che puoi associare gli agenti alle attività e definire l’ordine in cui vengono eseguite. Una volta avviato, il tuo sistema multi-agente fa partire la prima attività con l’agente assegnato, e il flusso continua a girare finché non ottieni il risultato.
Per quanto intuitivo, il flusso di controllo non è solido come in altre soluzioni, ma il team di CrewAI lo sa bene. Per questo ha sviluppato Flows, una funzione di instradamento più potente per quando devi unire la flessibilità del multi-agente ad azioni più strutturate, passo dopo passo.
- Vantaggi
- Facile da usare per prototipare rapidamente flussi di lavoro multi-agente
- ottime funzioni integrate di tracing e osservabilità
- due livelli di orchestrazione in un’unica piattaforma: attività/ruolo e instradamento/ramificazione
- Svantaggi
- Meno adatto per costruire sistemi a singolo agente e sistemi agentici, o per chi ha bisogno di funzioni più rigorose di gestione dello stato e del flusso di controllo
- Piani e prezzi
- Open source
- sulla versione ospitata è disponibile un piano gratuito con 50 esecuzioni al mese, oltre a un’interfaccia visiva e un copilot
- il piano Professional, a 25 dollari al mese, alza il limite a 100 esecuzioni di flussi di lavoro al mese, con una postazione in più e l’accesso al forum della community
- sono disponibili anche piani enterprise
3. LlamaIndex: il miglior strumento di orchestrazione IA per il RAG
Sulla carta il RAG sembra semplice, finché non ti trovi a costruire un sistema di domande e risposte con tanti dati molto simili tra loro, a volte in contraddizione, sparsi su decine di tipi di file. LlamaIndex lo rende il più semplice possibile nella pratica, con solide primitive per l’acquisizione, il chunking/embedding e il recupero, il tutto arricchito da ottimi strumenti di estrazione dei dati.
Si parte collegando le tue fonti dati a LlamaParse, una piattaforma di parsing documentale che trasforma i tuoi documenti in formati pronti per gli LLM. Man mano che i dati arrivano, vengono suddivisi in chunk, salvati nei nodi e contrassegnati con metadati. Per i PDF più ostici puoi usare una funzione con assistente IA che elabora i file con modelli come Gemini per comprendere, estrarre e salvare tutti i dati nel modo più accurato possibile.
Una volta caricati i documenti, memorizzati gli embedding e pronti gli indici, è il momento di lavorare sul recupero. Regolare il top-k non basta mai, ed è per questo che LlamaIndex offre tanti controlli per fare rerank, deduplicare, filtrare, aggiungere un bias sulla recency o usare qualsiasi altro metadato dei nodi per selezionare i chunk. Se durante una chat i risultati non rispettano gli standard di policy o conformità, puoi impostare il sistema perché riesegua il flusso RAG finché la risposta non è accettabile.
Usare LlamaIndex non introduce nuovi vettori di minaccia dal punto di vista della privacy o della sicurezza dei dati, o almeno non più di quanto non faccia qualsiasi altra libreria. Detto questo, il tuo livello di sicurezza dipende comunque da come e da quali sistemi i tuoi dati attraversano mentre viaggiano tra i servizi. Qui il protagonista è il RAG, quindi, anche se trovi il supporto per il tool-calling e per i flussi di lavoro generici, potrebbero mancare della potenza o della flessibilità di framework più specializzati.
- Vantaggi
- Permette di costruire in fretta un sistema RAG per domande e risposte, chat e agenti
- parsing solido per fonti dati disordinate
- funzioni avanzate per controllare il recupero
- Svantaggi
- Poco ricco di funzioni per il flusso di controllo dell’orchestrazione
- il parser è potente, ma poterne approfittare dipende dal fatto che rispetti o meno le tue policy: verificalo prima di impegnarti
- Piani e prezzi
- Open source, ospitabile in autonomia
- LlamaParse e LlamaCloud gestiti sono disponibili con un piano gratuito da 10.000 crediti
- il piano Starter, a 50 dollari al mese, include 40.000 crediti
4. Haystack: ideale per pipeline RAG modulari e pronte per la produzione
Haystack affronta l’orchestrazione IA come un framework di ingegneria. Il concetto di base è la pipeline vista come un multigrafo orientato: colleghi tra loro componenti tipizzati come retriever, ranker o costruttori di prompt. Questi componenti dichiarano degli ingressi e delle uscite con nome, così Haystack può verificare i tipi quando li colleghi. Questo rende più facile il debug mentre costruisci, soprattutto quando il progetto si fa più complesso o lavori in team.
Il motivo per cui si comporta così bene con il RAG è che hai subito a disposizione il recupero denso, sparso e ibrido, insieme a una guida alla scelta del ranker. Puoi adattare la configurazione in base alle reali esigenze del caso d’uso, bilanciando latenza, privacy e diversità secondo necessità. Mentre LlamaIndex ha un motore con scelte già impostate, Haystack mette tutti i pezzi sul tavolo, così puoi costruire esattamente ciò che vuoi.
La modularità va oltre i semplici tipi di componenti. Le pipeline si serializzano in YAML, così puoi versionarle in Git, modificarle senza toccare Python e ricaricarle con una sola chiamata di metodo. Sul fronte operativo, Haystack si integra in modo pulito con OpenTelemetry, così puoi inviare le trace a Langfuse, Datadog o SigNoz e vedere la latenza fase per fase lungo tutta la pipeline di recupero.
Per impostare Haystack dovrai scrivere più codice, soprattutto rispetto ad altri framework che si occupano di gran parte dei collegamenti al posto tuo. Ma questo lavoro iniziale in più ripaga: quando qualcosa si rompe in produzione, saprai esattamente quale componente andare a controllare, e quindi perderai meno tempo a sistemare le cose.
- Vantaggi
- Unisce un forte controllo del flusso al RAG; il modello mentale a pipeline, con componenti e connettori, semplifica il debug e il deployment ed è più stabile di altre soluzioni che evolvono più in fretta
- Svantaggi
- Tempi di configurazione più lunghi rispetto ad altri framework
- più elementi in gioco significano più decisioni da prendere, e questo può essere uno svantaggio se preferisci avere impostazioni predefinite solide fin da subito
- Piani e prezzi
- Open source, ospitabile in autonomia
- le opzioni ospitate tramite la piattaforma deepset AI sono gratuite fino a 100 ore di pipeline
- sono disponibili piani enterprise con prezzi e quote personalizzati
5. Prefect: ideale per orchestrare flussi di lavoro di dati e IA in Python
Quando lanci i tuoi script a mano, puoi arrivare in fondo a forza di tentativi, anche se questo significa rilanciare i job dopo un timeout o un errore 500 casuale. In produzione, però, le instabilità legate ai rate limit o ai passaggi che durano a lungo si traducono in lavoro perso. Invece di scrivere regole su regole per aggirare le stranezze dei servizi che usi, Prefect rende operativi i tuoi script Python, così i flussi di lavoro continuano ad andare avanti anche quando le dipendenze fanno i capricci.
La cosa migliore di Prefect è che non devi imparare nessun nuovo mini-linguaggio, framework o modello mentale complicato da costruire attorno al codice che hai già. Non esiste un «modo Prefect» di scrivere la tua logica di business: continui a scrivere normali funzioni Python, aggiungendo solo due decoratori per indicare un @task (un’unità di lavoro distinta e tracciabile) o un @flow (la funzione che orchestra le attività). Questi decoratori accettano parametri per i tentativi di ripetizione, il ritardo tra un tentativo e l’altro e molte altre proprietà configurabili, per assicurarsi che lo script si esegua come deve.
L’approccio basato sul Python puro si vede al momento dell’esecuzione: resta pur sempre uno script Python, ma ora con tracciamento dello stato, logging e tentativi di ripetizione così come li hai indicati nel decoratore. Le condizioni o i cicli che scrivi vengono eseguiti senza doverli dichiarare di nuovo da qualche altra parte. Tutto questo si sposa bene con le pipeline di IA e dati, perché il flusso di lavoro può restare dinamico mentre Prefect si occupa delle protezioni operative.
Quando sei pronto ad andare oltre l’esecuzione manuale degli script, puoi distribuirli in una rappresentazione del flusso lato server. Aggiungi una pianificazione, i parametri e poi scegli dove deve girare il flusso. Prefect ti permette di eseguire gli script tramite un processo locale, un container Docker o un job Kubernetes (tra gli altri) senza che tu debba toccare il codice.
Rispetto ad Airflow, Prefect risulta più flessibile e più facile da configurare, perché fai tutto in Python, senza mettere una grande piattaforma sotto la tua logica. Ma il rovescio della medaglia è proprio qui: devi gestire una parte maggiore dell’infrastruttura, soprattutto per quanto riguarda i worker e i work pool.
- Vantaggi
- Deployment e gestione operativa semplici
- interfaccia intuitiva per tenere traccia del «cosa, quando e dove» delle esecuzioni dei tuoi flussi di lavoro
- primitive integrate per la concorrenza e il rate limiting, così puoi applicare dei limiti su più flussi di lavoro che condividono API, GPU o database vettoriali
- Svantaggi
- La documentazione non rende evidente il modello mentale, quindi può essere più difficile capire le basi la prima volta che imposti un ambiente di produzione
- fa fatica in contesti multi-linguaggio e tra più sistemi
- Piani e prezzi
- Open source, ospitabile in autonomia
- è disponibile un piano gratuito ospitato fino a 5 deployment con 500 minuti di Prefect Serverless
- il piano Starter costa 100 dollari al mese per 20 deployment e 75 ore di Prefect Serverless
6. Apache Airflow: ideale per pipeline pianificate e flussi di lavoro IA in batch
Il punto di forza di Airflow è il modo in cui gestisce la parte meno affascinante del lavoro in produzione attorno all’IA, come le pipeline di feature pianificate, i processi da ETL a inferenza o i job di embedding in batch. Chiariamolo subito: non gestisce il runtime degli agenti, quindi se il tuo caso d’uso è coordinare più chiamate a un LLM per rispondere a una richiesta, è meglio orientarsi su un’altra opzione di questo elenco.
Definisci i flussi di lavoro come grafi aciclici orientati (DAG), scrivendo in Python i passaggi del tuo job e mostrando quali attività vengono prima e quali seguono. Poi ogni grafo viene eseguito a intervalli, che puoi impostare su base giornaliera, oraria o su qualsiasi altro periodo. Airflow parte solo dopo che quell’intervallo di tempo è trascorso, e questa è una delle sue funzioni migliori. I tuoi job lavorano su dataset stabili, puoi filtrare per data per capire quali dati sono stati elaborati, e questo si adatta bene al modo in cui i job in batch sono di solito legati a cose come «elaborare i dati della scorsa settimana» o «calcolare i punteggi dell’ultima ora».
Ci sono parecchi strumenti che ti aiutano quando qualcosa va storto. Airflow ha impostazioni integrate per rilanciare, recuperare e sistemare le esecuzioni basate sul tempo, così puoi riempire i vuoti o rieseguire tutto ogni volta che una pipeline fallisce o ti sfugge qualche dato. L’interfaccia utente di Airflow è la plancia di comando principale per questo: puoi selezionare un gruppo di attività fallite, azzerarle e riprovarle. Non risolverà per magia i guasti più seri, ma rende facile sistemare gli errori meno critici senza scrivere altro codice o passare ore a cercare il problema.
Oltre a guardare l’orologio e a far partire gli script, Airflow può anche supportare job che tengono conto di dataset e asset. Questo significa che può attivare i DAG quando i dati arrivano o si aggiornano davvero, così non devi essere prudente con gli intervalli di tempo né incrociare le dita sperando che tutto arrivi prima delle due di notte.
È una componente così importante dell’infrastruttura che quasi tutte le principali piattaforme cloud offrono una loro versione gestita, segno che è diventato lo standard minimo per un’orchestrazione batch affidabile. Se fai fatica a spostare i dati e passi troppo tempo tra ricerca dei problemi e correzioni, Airflow ti mette a disposizione una dashboard centralizzata e un kit di strumenti per il recupero che trasformano la gestione delle emergenze delle pipeline in qualche clic rilassato.
- Vantaggi
- Noioso nel senso buono del termine: affidabile e perfetto per i flussi di lavoro ripetibili che vuoi far eseguire in modo costante
- l’interfaccia di Airflow fa da vista principale sullo stato operativo ed è ottima per monitorare, risolvere i problemi e riprovare i flussi di lavoro
- maturo, molto diffuso e con una grande community
- Svantaggi
- Non è solo Python: è un’intera piattaforma, e questo porta con sé complessità e costi di manutenzione
- non è l’ideale per i carichi di lavoro in tempo reale o in streaming
- Piani e prezzi
- Open source, ospitabile in autonomia
- i servizi cloud gestiti dai principali provider possono costare tra i 450 e i 5.000 dollari al mese di spese per l’infrastruttura
7. Amazon Bedrock: ideale per l’orchestrazione cloud nativa su AWS
Il nome Bedrock è una scelta azzeccata per questo servizio di Amazon: un piano di controllo per l’IA generativa profondamente integrato con l’ecosistema AWS, che sfrutta tutte le tue configurazioni e le tue primitive operative già esistenti per aiutarti a costruire assistenti IA e funzionalità basate sull’IA. Il risultato è meno tempo speso a configurare e gestire i sistemi e più tempo per costruire e migliorare le tue app, le tue funzionalità e le tue pipeline.
Dispone di un hub di modelli con un ampio catalogo di modelli di base. L’attrazione principale è Claude (Amazon ha una partecipazione in Anthropic), ma sono disponibili anche Llama, Mistral, Amazon Titan/Nova e molti altri. Invece di registrarti separatamente presso ciascun provider e poi gestire chiavi, quote e aggiornamenti delle API, con Bedrock fai tutto in un unico posto. Questo rende anche più semplice fare A/B test tra le alternative, inserendo e togliendo i modelli, così puoi scegliere il giusto compromesso tra costo, qualità e latenza.
Bedrock offre un’orchestrazione nativa per l’IA tramite tre strumenti. Agents for Bedrock si occupa della prototipazione ad alto livello con pochissimo codice, mentre AWS esegue la logica dietro le quinte; AgentCore ti dà più controllo, permettendoti di eseguire il tuo framework di agenti o del codice personalizzato su un’infrastruttura serverless, con funzioni come la persistenza della memoria tra le sessioni e l’osservabilità; infine Bedrock Flows mette a disposizione un costruttore visuale di flussi di lavoro per progettare e realizzare flussi di IA generativa disponendo nodi e connessioni.
L’intera esperienza è ottimizzata per i team che lavorano in modo nativo su AWS, quindi se lo usi da anni ti sentirai subito a casa. È vero che le funzioni per gli assistenti IA e l’IA generativa rinunciano a un po’ di flessibilità in cambio di semplicità, ma Bedrock copre quasi tutte le capacità necessarie a costruire funzionalità per RAG, sistemi agentici e configurazioni multi-agente. In più, i costi ridotti di configurazione e manutenzione sono un altro buon motivo per scegliere Bedrock invece di guardare altrove.
- Vantaggi
- Bedrock si collega direttamente a IAM, semplificando la sicurezza
- un’unica API per molti modelli diversi
- i dati restano nel tuo account AWS
- Svantaggi
- Picchi di latenza dovuti alla multi-tenancy, e una documentazione poco accessibile e non sempre aggiornata
- Piani e prezzi
- In base al consumo
8. Google Vertex AI Agent Builder: ideale per l’orchestrazione cloud nativa su GCP
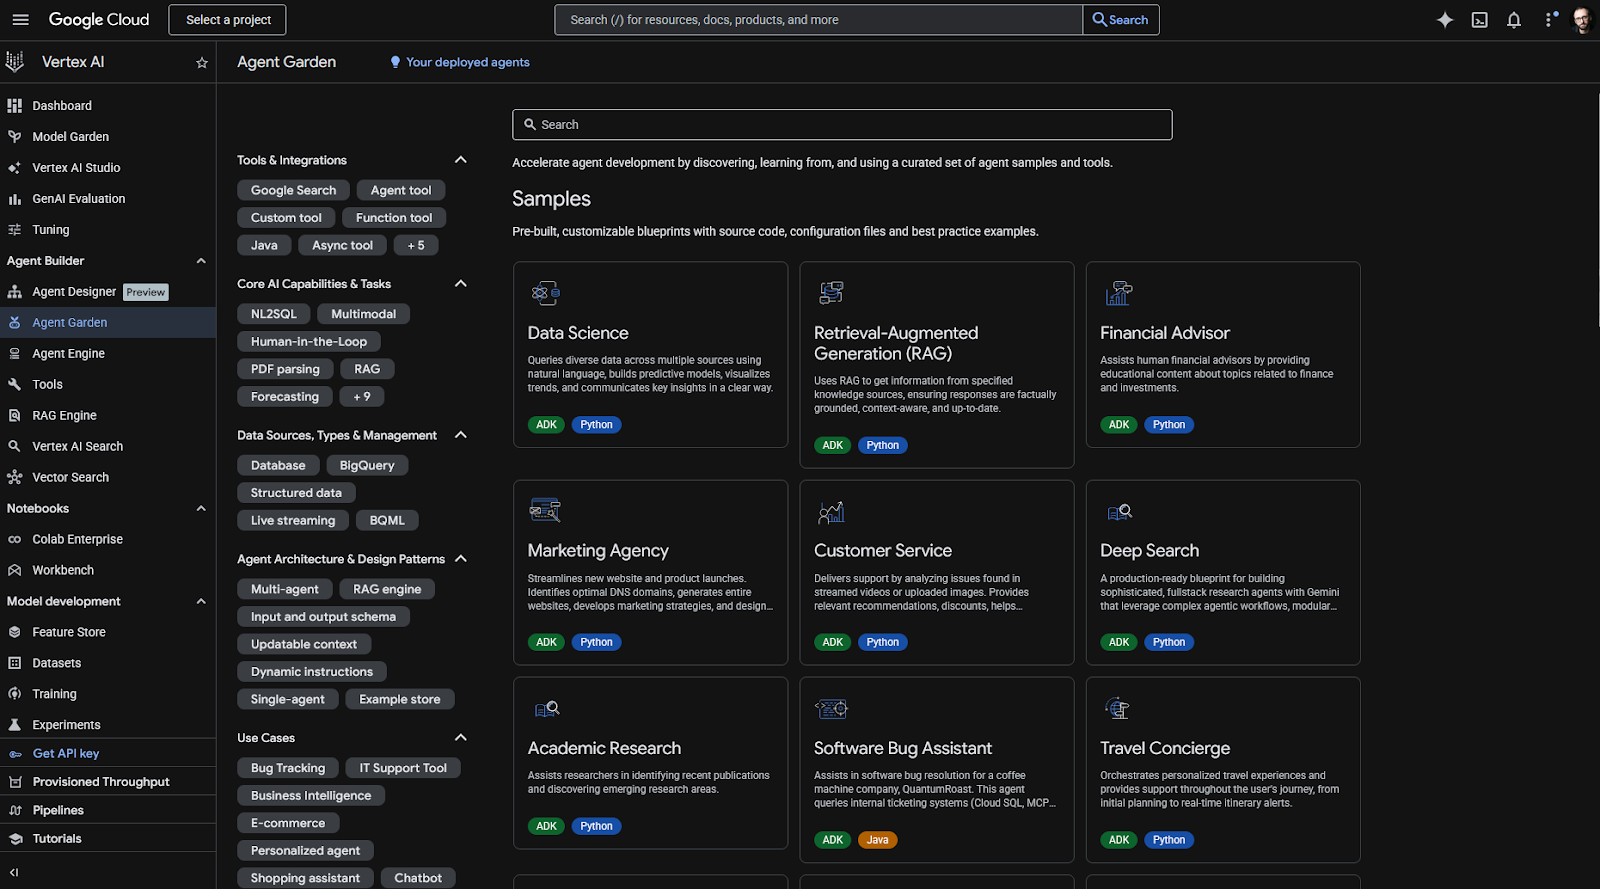
Vertex AI è la versione Google del Bedrock di Amazon e ne condivide tutti i vantaggi: avere più modelli e più strumenti di orchestrazione all’interno della tua piattaforma di cloud computing. Significa poter usare IAM per impostare i permessi sulle azioni dei modelli, un’API unificata per usare qualsiasi modello del suo ampio catalogo e sfruttare tutte le configurazioni e i dati che hai già su GCP.
Cosa cambia, allora? Il Model Garden di Google mette al timone i modelli Gemini, con le loro finestre di contesto enormi, le capacità di comprensione dei video e punteggi altissimi nei benchmark di intelligenza. Ci sono oltre 200 modelli tra cui scegliere, tra cui Llama, Mistral e Claude, per darti libertà senza costi di configurazione.
Se la ricerca è centrale per te, Vertex AI offre due modalità di grounding. Con il grounding tramite Google Search, Gemini si collega direttamente all’infrastruttura di ricerca web in tempo reale dell’azienda e restituisce risultati completi di citazioni e suggerimenti che puoi integrare nel front-end. La seconda è il grounding con Vertex AI Search, che attinge ai tuoi dati aziendali privati già indicizzati e funziona come un sistema RAG con una configurazione minima. Se serve, puoi combinare le due modalità e persino lasciare che sia il modello a scegliere quali strumenti usare per ogni query, così tieni meglio sotto controllo i costi.
Quando crei gli assistenti nel Vertex AI Agent Builder, puoi partire dal designer visuale low-code, da zero o da un modello. Ci sono connettori semplici agli strumenti nativi come BigQuery o Google Maps per velocizzare il lavoro. Se ti serve un controllo più preciso, puoi usare l’Agent Development Kit, che ti permette di definire l’esatta funzionalità con pochissimo codice di contorno. E per gli scenari avanzati, l’SDK di Vertex AI espone l’intera API di AgentEngine per un controllo completo.
Se i tuoi dati sono già su GCP, Vertex AI è la scelta più naturale, soprattutto per le sue solide capacità di grounding. Ma non si limita a questo ecosistema: Vertex AI supporta standard di interoperabilità come A2A e MCP, così i tuoi assistenti non restano vincolati a un unico framework. Questo lo rende una buona opzione anche per strategie miste o multi-cloud.
- Vantaggi
- Insieme all’IA generativa e agli assistenti sono incluse funzioni di machine learning come previsioni, scoring e personalizzazione
- puoi arrivare in produzione più in fretta, perché l’Agent Engine gestisce runtime, memoria, scalabilità e sessioni
- supporto per funzioni multimodali e in streaming con audio e video bidirezionali
- Svantaggi
- Per usarlo serve una buona padronanza dei concetti di base di GCP, e le integrazioni non Google sembrano trattate come cittadini di serie B
- Piani e prezzi
- In base al consumo
Come ho testato e scelto questi strumenti di orchestrazione dell’IA
Sono partito da una lista ristretta e ho poi ampliato la mia valutazione a 51 piattaforme di orchestrazione dell’IA, suddivise in quattro categorie: orchestrazione di assistenti, RAG, automazione dei flussi di lavoro e piattaforme di IA cloud. Nell’arco di un mese ho analizzato le pagine web e la documentazione di ogni piattaforma, tenendo d’occhio l’opinione degli sviluppatori e altri segnali che indicassero un giudizio positivo o negativo.
- Per l’orchestrazione degli assistenti ho dato priorità a modelli concettuali semplici, capaci di costruire configurazioni a singolo e multi-agente su architetture basate su grafi, con solide funzioni di debug e osservabilità.
- Per il RAG ho valutato l’intera pipeline, dall’acquisizione e dall’analisi dei documenti (incluse le integrazioni disponibili con le fonti di dati e la facilità di connessione) fino a quanto possono essere granulari i controlli sul recupero.
- Per i flussi di lavoro i criteri decisivi riguardavano le basi della messa in esercizio: rilanci, timeout e condizioni di esecuzione. Qui ho fatto attenzione al peso di configurazione e manutenzione.
- Per l’IA cloud ho cercato un equilibrio tra la posizione della piattaforma sul mercato, le funzioni di IA disponibili e la facilità di distribuzione e manutenzione.
Ogni strumento selezionato è passato per una prova pratica: ho realizzato progetti introduttivi, allestito ambienti di lavoro e ampliato i progetti iniziali per mettere alla prova le funzioni principali di ciascuna piattaforma. Visto che non potevo realisticamente sottoporre tutti gli strumenti all’intera gamma di sfide di produzione, mi sono anche immerso nelle issue aperte, nelle discussioni della community e nei report sui bug, per capire i limiti e come viene gestito ogni caso particolare.
Usa gli Assistenti IA Jotform per automatizzare i tuoi flussi di lavoro senza fatica
Le pipeline di orchestrazione valgono tanto quanto i dati che ci fai entrare. Prima che i tuoi assistenti possano agire, qualcosa deve raccogliere dati puliti, ed è qui che entra in gioco Jotform. Con i moduli online di Jotform puoi costruire interfacce affidabili per la raccolta dei dati, che diventano il punto di partenza per attivare assistenti e grafi personalizzati.
Ma la raccolta dati è solo l’inizio. Jotform AI Agents è una piattaforma agentica completa per l’automazione dei flussi di lavoro con l’IA: collega gli LLM a basi di conoscenza e chiamate a strumenti per agire su sistemi esterni, il tutto in un’esperienza no-code. Significa che tu (e i tuoi team senza competenze tecniche) potete mettere in funzione in fretta assistenti che usano i tuoi dati per fornire assistenza clienti o per la gestione dei progetti con l’IA. La tua azienda può iniziare con l’automazione dei processi tramite IA senza sovraccaricare gli sviluppatori di arretrati.
Questo stack tecnologico di prima linea dispone di un’ampia libreria di integrazioni e di supporto ai webhook. Una volta raccolti, i dati possono avviare processi a valle, come l’aggiornamento di una piattaforma di gestione delle relazioni con i clienti o l’invio di un evento al tuo livello di orchestrazione. Portare Jotform tra i tuoi strumenti significa dedicare meno tempo a costruire interfacce ed esperienze utente, e più tempo a lavorare sulla logica che conta davvero.
Che tipo di builder sei?
Come scegli, allora, lo strumento di orchestrazione dell’IA giusto per te? La maggior parte dei sistemi di IA in produzione ha bisogno di due livelli:
- Qualcosa che gestisca il comportamento a runtime dei tuoi assistenti o della tua pipeline RAG
- Qualcosa che pianifichi, riprovi e metta in esercizio quel lavoro nel tempo
Se stai costruendo assistenti con stato e un flusso di controllo complesso, LangGraph è tra i migliori framework per assistenti IA sul fronte del runtime. Abbinalo a Prefect per una pianificazione leggera, oppure ad Airflow se ti stai collegando a un’infrastruttura di dati già esistente.
Per la collaborazione tra più assistenti, CrewAI ti porta rapidamente a un prototipo funzionante. Si occupa anche di gran parte dell’orchestrazione dietro le quinte, quindi potresti non aver bisogno di un livello di flusso di lavoro separato finché non inizi a scalare.
Negli scenari RAG, il motore con scelte già definite di LlamaIndex permette una configurazione più rapida, mentre Haystack parte più lento ma offre un controllo più forte sulla pipeline man mano che cresci. Entrambi si abbinano bene a Prefect.
Per quanto riguarda l’orchestrazione cloud, scegliere AWS o GCP significa rinunciare a un po’ di flessibilità in cambio di molto meno lavoro di configurazione e manutenzione. È la scelta migliore per i team che non vogliono dover gestire di continuo il lato infrastrutturale del runtime degli assistenti.
Se non è ancora del tutto chiaro, ecco come individuare la combinazione vincente per il tuo team: metti prima a posto il runtime, poi aggiungi l’orchestrazione del flusso di lavoro con l’IA una volta che sai davvero cosa stai orchestrando.
Questo articolo si rivolge a un pubblico tecnico di livello intermedio e avanzato: ingegneri IA/ML, sviluppatori, data engineer e architetti di soluzioni che stanno valutando framework di orchestrazione per assistenti, pipeline RAG o pianificazione dei flussi di lavoro.













Invia un Commento: