
主要なAIオーケストレーションツール
AIオーケストレーションとは、AIアシスタントやエージェント、データパイプラインといったさまざまな要素をつなぎ合わせ、ひとつのシステムとして動かして複雑なタスクをこなせるようにする、いわば調整役の層です。この層が、何を、いつ、どこで実行するかを決めます。さらに、システムが動いている間のモニタリングやデバッグ、運用上のトラブル対応に役立つツールも提供してくれます。
このオーケストレーション層をうまく扱えるようになると、運用がスムーズになるだけではありません。自律型AIエージェントへの道が開け、受け身だったインフラを先回りして動くものへと変えていけます。それでは、2026年にAI開発を効率化してくれる、おすすめのAIオーケストレーションツールを詳しく見ていきましょう。


AIオーケストレーションの4つのタイプ
「オーケストレーション」という言葉は、AIスタックのほぼすべての層で登場します。ただ、実際に何を調整しているのかは層によって大きく異なります。そこで、この幅広いカテゴリを4つのグループに分けてみました。各プラットフォームがどの層を対象にしているのかが分かれば、候補を絞り込んで自分に合ったツールをすばやく見つけられます。
エージェントのオーケストレーション
エージェントのオーケストレーションは、エージェントがタスクをやり遂げるまでに関わるすべてをカバーします。役割を決めたり、処理の流れを管理したり、各ステップが実行される条件を設定したりといった作業です。さらに、複数のエージェントが対等に協力し合う構成や、階層構造で動く構成も含まれます。
何を調整するのか
- どのエージェントが、どのタスクを、どんな順番で、どんな条件のもとで処理するか。処理の道筋が一直線でないときに、どう判断を下すかも含まれます
- 会話履歴やツールへのアクセス、データソース、ガードレールといった共有コンテキストやリソースを管理し、すべてのエージェントが一貫して参照できるようにすること
RAGのオーケストレーション
検索拡張生成(RAG)のオーケストレーションツールは、ナレッジベースを準備し、実行時にそれを効率よく検索するパイプラインを管理します。これによって、エージェントは根拠に基づいた正確な回答を生成できます。こうしたツールを使えば、データの取り込みやインデックス作成から、クエリ処理や検索まで、両方のフェーズをコントロールできます。
何を調整するのか
- ナレッジの準備。ドキュメントの取り込み、テキストの抽出、チャンク化、検索可能なインデックスや埋め込みの作成などが含まれます
- 実行時の検索と生成。ユーザーの質問を処理し、関連する内容を取得してランク付けし、プロンプトのコンテキストを組み立て、根拠のある回答を生成するまでを指します
ワークフローのオーケストレーション
ワークフローのオーケストレーションプラットフォームは、不安定だったり結果がばらついたりするエンドツーエンドのプロセスを、毎回同じように実行されるアクションへと変えてくれます。依存関係を管理し、失敗をモニタリングし、再試行やバックフィルも手軽に行える仕組みを備えています。
何を調整するのか
- タスクの順序と依存関係。ステップの並び順、最初に実行しなければならないもの、並行して実行できるタスクの範囲などです
- 引き継ぎ、データの流れ、実行ルール。データや出力がシステム間をどう移動するか、そしてワークフローを動かし続けるための条件や再試行、例外処理などが含まれます
クラウドのオーケストレーション
クラウドオーケストレーションのAIプラットフォームを使うと、自社のクラウドインフラ上でエージェントを構築し、デプロイし、管理できます。データやサービスにネイティブにアクセスでき、ID・アクセス管理(IAM)もすでに統合されているので、アイデアを余計な設定なしで実際に動くエージェントへとつなげられます。
何を調整するのか
- リソースのプロビジョニングと構成。クラウド環境全体にわたるコンピューティング、ストレージ、ネットワーク、セキュリティの各要素を自動で管理してくれるので、構築作業に集中できます
- エージェントのデプロイと管理。既存のクラウドサービスや権限をそのまま使って、エージェントの作成、デプロイ、スケールをすばやく始められるルートが用意されており、インフラを手作業で管理する必要がありません
開発者におすすめのAIオーケストレーションツール8選
| ツール | カテゴリ | 適した用途 | デプロイ |
|---|---|---|---|
 LangGraph |
エージェントのオーケストレーション |
状態を保持できて制御しやすいエージェントワークフロー(分岐やループを含むグラフ、長時間実行、チェックポイント方式のパターンなど)。エージェントのステップや状態を自分でしっかり制御したい場合に向いています |
|
 CrewAI |
エージェントのオーケストレーション |
役割ベースで複数のエージェントが協力し合う構成(タスクや役割を持った「エージェント」のチーム)。特に「組織図」のようなイメージで考えたいときや、マルチエージェントのプロトタイプをすばやく作りたいときに向いています |
|
 LlamaIndex |
RAGのオーケストレーション |
取り込み・チャンク化・検索の抽象化が充実したRAGアプリや「ドキュメントから回答を導く」システム。多くのデータソースやベクトルデータベースと組み合わせて使うのに適しています |
|
 Haystack |
RAGのオーケストレーション |
本番環境向けのRAGパイプライン(コンポーネント/パイプライン方式)。retriever・ranker・generatorを柔軟なグラフとして組み合わせたいときや、しっかりしたデプロイパターンが欲しいときに向いています |
|
 Prefect |
ワークフローのオーケストレーション |
データやAIのパイプライン向けのモダンなPythonワークフローとスケジューリング(再試行、キャッシュ、可観測性)。「従来型のスケジューラー」よりもスムーズな開発体験が得られます |
|
 Apache Airflow |
ワークフローのオーケストレーション |
スケジュール実行のバッチオーケストレーション(DAGベースのETL/ELT、定期ジョブ)。巨大なエコシステムと「業界標準」のパターンを備えています |
|
 Amazon Bedrock |
クラウドのオーケストレーション |
AWSネイティブの生成AIプラットフォーム/オーケストレーション。マネージドなモデルアクセスとAWSのセキュリティ・ガバナンスを使いたいときや、AWSの各種サービスと緊密に連携させたいときに向いています |
|
 Google Vertex AI Agent Builder |
クラウドのオーケストレーション |
GCPネイティブなエージェント構築とガバナンス(特にすでにGoogle Cloudを使っている企業向け)。マネージドなインフラでエージェントをデプロイしたいときに向いています |
|
1. LangGraph:複雑で状態を持つエージェントの制御フローに最適
理想を言えば、AIエージェントによるカスタマーサポートはバグもエラーもなく動いてほしいものです。でも現実はそうはいきません。LangGraphの状態管理と制御フローの機能を使えば、開発・改善・問題解決がやりやすくなります。新しいバージョンをすばやくデプロイし、ミスも素早く直せるというわけです。
ここでユニークなのが、入力や出力、そのほかタスクを完了するのに必要なデータを格納するフィールドを使って、自分で定義する「状態(state)」です。この状態はグラフに沿って受け渡され、新しいデータが少しずつマージされて、最終的に完成していきます。
デバッグの際は、状態を見るだけでもフローのどこで失敗したかの手がかりがつかめます。さらにチェックポイント機能を有効にすると、LangGraphはすべてのステップとアクションをデータベースに記録します。これはデバッグだけでなく、特定の地点まで巻き戻すことにも使えます。一つひとつのステップを追って何が起きているかを確認したり、過去の実行を新しいアーキテクチャで試してみたりすることもできます。
このフレームワークはモジュール式で、オーケストレーションのフローを書き換えなくても、データ連携やLLM、外部APIを簡単に追加・削除・変更できます。さらに、LLMを扱うためのLangChainと、評価や可観測性のためのLangSmithも使えるので、独自モデルの制御、柔軟なオーケストレーション、フィードバックループまで、ひと通りそろった形になります。
- 良い点
- データや機能を失わずに、どのタイミングでもワークフローを中断・再開できる
- 任意のタイミングで人の判断を挟む(human-in-the-loop)割り込みを簡単に組み込める
- ノードやノード間のエッジ、条件分岐によるルーティングを宣言することで、制御フローを明示的に表現できる
- 気になる点
- 従来のパイプライン型の考え方に慣れていると、状態やグラフの発想は最初は直感的に理解しづらい。チェックポイントのデータ管理や割り込みの扱いも大きな悩みどころ
- プランと料金
- オープンソースでセルフホスト可能
- 無料プランあり(基本トレース5,000件、Agent Builder 1つ、月50回の実行)
- Plusプランは1シートあたり月39ドル(基本トレース10,000件、Agent Builder無制限、月500回の実行)。プランの上限を超えると従量課金になる
- エンタープライズ向けのオプションも用意されている
2. CrewAI:役割ベースのマルチエージェント連携に最適
名前のとおりです。CrewAIは、あなた専用のAIエージェントの「クルー(crew)」を組み立てるためのものです。本質的にはマルチエージェントのシステムで、その考え方は人間の会社と同じです。エージェントにはそれぞれ役割と能力があり、こなすべきタスクがあります。誰が何をやるのか、タスクのコンテキストをどうつなぐのか、どんな要件があるのかを、あなたが定義していきます。
エージェントのクラスには、役割(role)、目標(goal)、背景設定(backstory)を渡せて、これがシステムへの指示として機能します。エージェントにはツールを紐づけることもできるので、Web検索をさせたり、社内のナレッジベースを調べさせたり、ほかの外部システムとやり取りさせたりできます。さらに、特定の分野に特化した専門家としてエージェントを作り込むこともでき、それぞれをバーティカルAIのかなり的を絞った実装にできます。
次にタスクですが、説明(description)と期待する出力(expected output)、つまり「何をもって完了とみなすか」という一連の要件を受け取ります。これらも平易な言葉で書けて、ユーザーがチャットボットに打ち込むようなプロンプトによく似ています。エージェントではなくタスクのほうにツールを紐づけることもできますが、それ以上に大事なのは、前のタスクからコンテキストを引き継げる点です。フローが進んでも、同じ流れの上に積み重ねていけるというわけです。
すべてをcrew関数でつなぐときには、使えるエージェントとこなすべきタスクをすべて列挙します。ここでエージェントをタスクに割り当て、実行する順番を決めます。実行すると、マルチエージェントのシステムが最初のタスクを担当エージェントとともに起動し、出力が得られるまでフローが走り続けます。
直感的に使える一方で、制御フローはほかの選択肢ほど強力ではありません。ただ、CrewAIのチームもそこは分かっています。そこで開発されたのがFlowsで、マルチエージェントの柔軟さと、よりきっちりしたステップごとのアクションを組み合わせたいときに役立つ、強力なルーティング機能です。
- 良い点
- マルチエージェントのワークフローをすばやくプロトタイプしやすい
- トレースと可観測性の機能が標準で充実している
- タスク/役割と、ルーティング/分岐という2層のオーケストレーションを1つのプラットフォームで扱える
- 気になる点
- 単一エージェントやエージェント型システムの構築、あるいは状態や制御フローをもっと厳密に扱いたい場合には、あまり向いていない
- プランと料金
- オープンソース
- ホスト版には月50回の実行が可能な無料プランがあり、ビジュアルインターフェースとコパイロットも使える
- 月25ドルのProfessionalプランでは上限が月100回のワークフロー実行に上がり、シートが1つ追加され、コミュニティフォーラムにもアクセスできる
- エンタープライズプランも用意されている
3. LlamaIndex:RAGに最適なAIオーケストレーションツール
RAGは紙の上では単純に見えますが、何十種類ものファイル形式にまたがって、よく似た、ときには矛盾するデータがたくさんあるQ&Aシステムを作ろうとすると、話は変わってきます。LlamaIndexは、取り込み、チャンク化/埋め込み、検索のための強力な基本機能に、優れたデータ抽出ツールを組み合わせて、実際の運用をできるだけシンプルにしてくれます。
まずはデータソースをLlamaParseにつなぎます。これはドキュメントをLLMが扱いやすい形式に変換する、ドキュメント解析のプラットフォームです。データが流れ込むと、チャンクに分割され、ノードに保存され、メタデータでタグ付けされます。扱いにくいPDFには、AIエージェント機能を使えます。これはGeminiのようなモデルを使ってファイルを処理し、できるだけ正確にデータを理解・抽出・保存してくれます。
ドキュメントを取り込み、埋め込みを保存し、インデックスが整ったら、次は検索です。top-kを調整するだけでは足りません。だからこそLlamaIndexには、再ランク付け、重複排除、フィルタリング、新しさの重み付けなど、チャンクを選ぶためのさまざまな調整機能が用意されており、ほかのノードのメタデータも使えます。チャット中に結果がポリシーやコンプライアンスの基準を満たさない場合は、応答が受け入れられる水準になるまでRAGのフローを再実行するように設定できます。
LlamaIndexを使うことで、データのプライバシーやセキュリティの面で新たな脅威が増えることはありません。少なくとも、ほかのライブラリを使う場合以上に増えることはないでしょう。とはいえ、セキュリティの強さは、データがサービス間を移動する際にどのシステムに、どう触れるかによって変わってきます。ここで主役になるのはあくまでRAGです。ツール呼び出しや一般的なワークフローにも対応していますが、より専門的なフレームワークほどの力や柔軟さはないかもしれません。
- 良い点
- Q&A、チャット、エージェント向けのRAGシステムをすばやく構築できる
- 雑多なデータソースにも強い解析機能
- 検索を細かく制御できる高度な機能
- 気になる点
- オーケストレーションの制御フロー機能は手薄
- パーサーは強力だが、使いこなせるかは自社のポリシーに準拠しているか次第。導入前に確認を
- プランと料金
- オープンソースでセルフホスト可能
- マネージドのLlamaParseとLlamaCloudは、10,000クレジット付きの無料プランで使える
- 月50ドルのStarterプランには40,000クレジットが含まれる
4. Haystack:モジュール式で本番向けのRAGパイプラインに最適
Haystackは、AIオーケストレーションをエンジニアリング用のフレームワークとして捉えています。中心にあるのは、有向マルチグラフとしてのパイプラインという考え方です。リトリーバーやランカー、プロンプトビルダーといった型付きのコンポーネントをつないでいきます。これらのコンポーネントは名前付きの入出力ソケットを宣言するので、つなぐときにHaystackが型をチェックしてくれます。おかげで作りながらのデバッグがしやすく、プロジェクトが複雑になってきたときや、チームで作業するときにとくに役立ちます。
RAGに強い理由は、密(dense)、疎(sparse)、ハイブリッドの検索が最初から使え、ランカー選びのガイドまで用意されているからです。実際のユースケースの要件に合わせて構成を調整でき、レイテンシ、プライバシー、多様性を必要に応じて取ることができます。LlamaIndexが決め打ちのエンジンを持っているのに対し、Haystackはすべての部品をテーブルの上に並べてくれるので、思いどおりのものを組み上げられます。
モジュール性は、コンポーネントの種類だけにとどまりません。パイプラインはYAMLにシリアライズできるので、Gitでバージョン管理し、Pythonに触れずに編集し、メソッドを1回呼ぶだけで再読み込みできます。運用面でも、HaystackはOpenTelemetryにきれいに対応しているので、トレースをLangfuse、Datadog、SigNozに流し込み、検索パイプライン全体でステージごとのレイテンシを把握できます。
Haystackのセットアップには、ほかのフレームワーク、とくに配線の多くを肩代わりしてくれるものと比べて、より多くのコードを書くことになります。それでも、この初期セットアップの手間はちゃんと報われます。本番で何か壊れたとき、どのコンポーネントを見ればいいかがすぐ分かるので、修正にかかる時間が短くて済むのです。
- 良い点
- 高度なフロー制御とRAGを両立できる。コンポーネントとコネクターによるパイプライン型の考え方でデバッグやデプロイがしやすく、進化の速いほかの選択肢よりも安定している
- 気になる点
- ほかのフレームワークと比べてセットアップに時間がかかる
- 可動部分が多いぶん決めることも増えるので、最初から強力なデフォルトがほしい人にはかえって負担になりうる
- プランと料金
- オープンソースでセルフホスト可能
- deepset AIプラットフォーム経由のホスト版は、100パイプライン時間まで無料で使える
- 料金や上限をカスタマイズできるエンタープライズプランも用意されている
5. Prefect:PythonでデータとAIのワークフローをオーケストレーションするのに最適
スクリプトを手動で動かしているうちは、タイムアウトや突然の500エラーのあとにジョブを回し直してでも、力ずくで最後までたどり着けます。ところが本番環境では、レート制限や長時間かかる処理まわりの不安定さが、そのまま作業の損失につながります。使っているサービスの癖を回避するためのルールを延々と書き足す代わりに、PrefectはあなたのPythonスクリプトを運用に乗せてくれます。依存先のご機嫌が悪くても、ワークフローは止まらずに進み続けます。
Prefectのいちばんいいところは、既存のコードを包むために、新しいミニ言語やフレームワーク、複雑な考え方を覚える必要がない点です。ビジネスロジックを書くうえで「Prefect流」といったものはありません。これまでどおり普通のPython関数を書きつつ、デコレーターを2つ足すだけです。1つは@task(追跡できる個別の作業単位)、もう1つは@flow(タスクをまとめて動かす関数)を示すものです。これらのデコレーターは、リトライ回数やリトライ間隔など、スクリプトが思いどおりに動くよう設定できるさまざまなパラメーターを受け取ります。
純粋なPythonであることは、実行時にもはっきり表れます。中身は相変わらずPythonスクリプトですが、デコレーターで指定したとおりに状態の追跡、ログ記録、リトライが備わっています。書いた条件分岐やループは、どこか別の場所で改めて宣言しなくてもそのまま実行されます。これはAIやデータのパイプラインによく合います。ワークフローは動的なまま保ちつつ、運用上のガードレールはPrefectが引き受けてくれるからです。
スクリプトを手動で動かす段階を抜け出す準備ができたら、フローをサーバー側の表現としてデプロイできます。スケジュールとパラメーターを設定し、フローをどこで動かすかを選びます。Prefectなら、ローカルプロセス、Dockerコンテナ、Kubernetesジョブなど、さまざまな場所でスクリプトを実行でき、しかもコードに手を入れる必要はありません。
Airflowと比べると、Prefectのほうが柔軟でセットアップも楽に感じられます。ロジックの下に大きなプラットフォームを足すことなく、すべてをPythonで完結できるからです。その代わり、ここにトレードオフもあります。とくにワーカーやワークプールまわりでは、インフラの面倒をより多く自分で見ることになります。
- 良い点
- デプロイと運用が簡単
- ワークフローの実行が「何を・いつ・どこで」行われたかを追える、直感的なインターフェース
- 並行処理とレート制限の仕組みが標準で用意されており、APIやGPU、ベクトルデータベースを共有する複数のワークフローにまたがって上限をかけられる
- 気になる点
- ドキュメントが考え方をはっきり示してくれないので、初めて本番環境を組むときは基本を理解しにくいことがある
- 複数言語やシステムをまたぐ構成では力不足
- プランと料金
- オープンソースでセルフホスト可能
- ホスト版の無料プランでは、デプロイ5件まで、Prefect Serverless 500分までが使える
- 月100ドルのStarterプランでは、デプロイ20件とPrefect Serverless 75時間が使える
6. Apache Airflow:スケジュール実行のパイプラインやバッチAIワークフローに最適
Airflowがいちばん得意なのは、AIまわりの本番運用の地味な部分です。たとえば、定期実行する特徴量パイプライン、ETLから推論までの流れ、バッチの埋め込みジョブなどです。最初にはっきりさせておくと、Airflowはエージェントのランタイムは扱いません。複数のLLM呼び出しを連携させて1つのリクエストに応答させたいなら、このリストのほかの選択肢を選ぶのがいいでしょう。
ワークフローは有向非巡回グラフ(DAG)として定義します。ジョブのステップをPythonで書き、どのタスクが先でどれが後に続くかを示していくわけです。各グラフは一定の間隔で実行され、毎日、1時間ごとなど、好きな周期に設定できます。指定した時間が経ってから初めて動く点は、Airflowの優れた特徴の1つです。ジョブは安定したデータセットを対象にでき、どのデータが処理されたかを時間で絞り込めます。これは「先週のデータを処理する」「直近1時間分をスコアリングする」といった、バッチジョブにありがちな時間軸ともよくかみ合います。
うまくいかないときに頼れるツールもそろっています。Airflowには、再実行、キャッチアップ、時間ベースの実行の修復といった設定が最初から備わっており、パイプラインが失敗したりデータを取りこぼしたりするたびに、バックフィルや再実行ができます。その中心になるのがAirflowのユーザーインターフェースです。失敗したタスクをまとめて選び、クリアしてやり直せます。深刻な障害を魔法のように解決してくれるわけではありませんが、影響の小さいエラーなら、追加のコーディングや長いトラブルシューティングなしに手早く直せます。
時計を見てスクリプトを起動するだけでなく、Airflowはデータセットやアセットを意識したジョブにも対応します。つまり、データが実際に届いたり更新されたりしたタイミングでDAGを起動できるのです。おかげで時間間隔を慎重に取りすぎる必要はなく、午前2時までにすべてが届くようにと祈る必要もありません。
インフラの一部としてあまりに広く使われているため、ほぼすべての主要クラウドプラットフォームが独自のマネージド版を用意しているほどです。信頼性の高いバッチオーケストレーションでは、もはや当たり前の存在になったということでしょう。データの受け渡しに手を焼き、トラブルシューティングや修正に時間を取られすぎているなら、Airflowは一元化されたダッシュボードと復旧用のツール群を提供してくれます。パイプラインの火消しが、落ち着いた数クリックの作業に変わります。
- 良い点
- いい意味で地味で、信頼でき、毎回安定して動かしたい繰り返しのワークフローにぴったり
- Airflowのインターフェースは運用の健全性を見渡す中心となり、ワークフローの監視、トラブルシューティング、再実行にとても向いている
- 成熟していて広く使われており、大きなコミュニティがある
- 気になる点
- 単なるPythonではなくプラットフォームそのものなので、複雑さと保守の手間がついてくる
- リアルタイムやストリーミングの処理には向いていない
- プランと料金
- オープンソースでセルフホスト可能
- 主要プロバイダーが提供するマネージドクラウドサービスの場合、インフラ費用は月450ドルから5,000ドルほどになる
7. Amazon Bedrock:AWSネイティブなクラウドオーケストレーションに最適
Bedrock(岩盤)という名前は、このAmazonのサービスにぴったりです。AWSのエコシステムに深く組み込まれた生成AIのコントロールプレーンで、すでに使っている構成や運用の仕組みをそのまま活かしながら、エージェントやAI機能を作れます。つまり、システムのセットアップや運用に費やす時間が減り、アプリや機能、パイプラインを作り込み、磨き上げる時間を増やせるということです。
Bedrockには、豊富な基盤モデルをそろえたモデルハブがあります。目玉はClaude(AmazonはAnthropicに出資しています)で、ほかにもLlama、Mistral、Amazon Titan/Nova など多数が使えます。これらのプロバイダーに個別にサインアップして、キーやクォータ、APIの更新を自分で管理する必要はなく、すべてBedrock内で完結します。モデルを差し替えるだけで代替案をA/Bテストしやすくなるので、コスト・品質・レイテンシのバランスを自分で選べます。
Bedrockは、3つのツールでAIネイティブなオーケストレーションを実現します。Agents for Bedrockは、最小限のコードで高レベルのプロトタイピングを担い、ロジックは裏側でAWSが動かします。AgentCoreはより細かく制御でき、独自のエージェントフレームワークやカスタムコードをサーバーレスのインフラ上で動かせて、セッションをまたいだメモリの保持や可観測性といった機能も備えています。そしてBedrock Flowsは、ノードとその接続を並べて生成AIのワークフローを設計・実装できる、ビジュアルなワークフロービルダーです。
すべての体験がAWSネイティブのチーム向けに最適化されているので、何年もAWSを使ってきた人ならすぐになじめます。エージェントや生成AIの機能は、柔軟性を手放す代わりに手軽さを得ているものの、RAGやエージェント型システム、マルチエージェント構成の機能を作るのに必要な能力は、Bedrockでほぼ網羅できます。しかも、セットアップと保守の手間が少なくて済むことも、外に目を向けるよりBedrockを選ぶ理由になります。
- 良い点
- BedrockはIAMに直接つながるので、セキュリティ管理がシンプルになる
- 多くのモデルを1つのAPIで扱える
- データは自分のAWSアカウント内にとどまる
- 気になる点
- マルチテナントが原因でレイテンシが急に跳ね上がることがあり、ドキュメントもあまり親切でなく、最新とは言いがたい
- プランと料金
- 従量課金制
8. Google Vertex AI Agent Builder:GCPネイティブなクラウドオーケストレーションに最適
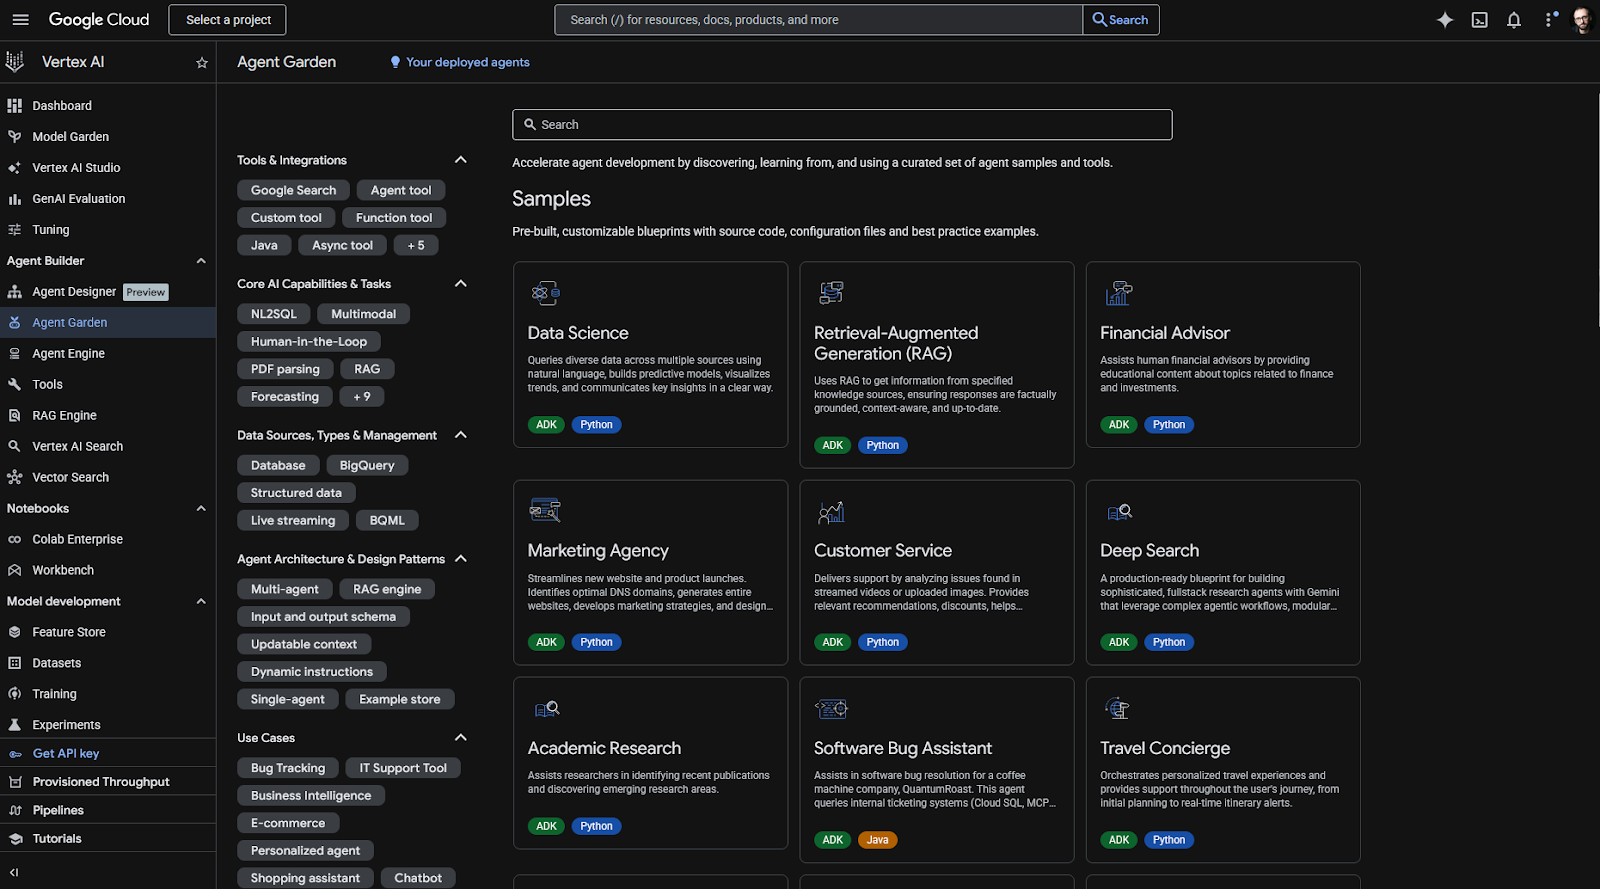
Vertex AIは、言ってみればAmazon BedrockのGoogle版です。複数のモデルとオーケストレーションツールを自分のクラウド基盤の中に持てるという利点は、そっくり共有しています。つまり、モデルの動作に対する権限をIAMで設定でき、豊富なカタログの中のどのモデルも統一されたAPIから使え、GCPにある既存の設定やデータをそのまま活かせます。
では何が違うのでしょうか。GoogleのModel Gardenでは、Geminiモデルが主役です。きわめて長いコンテキストウィンドウ、動画の理解機能、高い知能ベンチマークが持ち味です。選べるモデルは200を超え、Llama、Mistral、Claudeなども含まれます。セットアップの手間なしに自由度を得られるわけです。
検索が中核になるなら、Vertex AIには2つのグラウンディングモードがあります。1つはGoogle検索によるグラウンディングで、Geminiを同社のライブなウェブ検索インフラに直接つなぎ、引用元や関連候補を含む検索結果を返してくれます。これをそのままフロントエンドに組み込めます。もう1つはVertex AI Searchによるグラウンディングで、あらかじめインデックス化した社内の機密データを掘り下げ、ほとんど設定なしでRAGシステムとして機能します。必要なら両方を組み合わせることもでき、クエリごとにどのツールを使うかをモデル自身に選ばせて、コストをより抑えることもできます。
Vertex AI Agent Builderでエージェントを作るときは、ローコードのビジュアルデザイナーから始められます。ゼロから組んでも、テンプレートを使っても構いません。BigQueryやGoogle Mapsといったネイティブツールへの手軽なコネクタがあり、作業を速められます。もっと細かく制御したいなら、Agent Development Kitを使い、最小限の定型コードで必要な機能を正確に定義できます。高度なシナリオでは、Vertex AI SDKがAgentEngine APIをすべて公開しており、完全にコントロールできます。
データがすでにGCPにあるなら、Vertex AIは自然な選択です。特に強力なグラウンディング機能が光ります。このエコシステムの外でも、Vertex AIはA2AやMCPといった相互運用の標準に対応しているので、エージェントが1つのフレームワークに縛られることはありません。混在環境やマルチクラウドの戦略をとる場合にも、よい選択肢になります。
- 良い点
- 予測、スコアリング、パーソナライズといった機械学習の機能が、生成AIやエージェントと一緒に使える
- Agent Engineがランタイム、メモリ、スケーリング、セッション管理を引き受けてくれるので、本番環境まで一気に進められる
- 双方向の音声・動画にわたるマルチモーダルとストリーミングの機能に対応
- 気になる点
- 使いこなすにはGCPの基本概念にしっかり慣れている必要があり、Google以外の連携はどうしても扱いが二の次に感じられる
- プランと料金
- 従量課金制
これらのAIオーケストレーションツールをどう試し、どう選んだか
最初に候補をいくつか絞り込み、そこから評価対象を51のAIオーケストレーションプラットフォームまで広げました。カテゴリーは、エージェントオーケストレーション、RAG、ワークフロー自動化、クラウドAIプラットフォームの4つです。1か月かけて各プラットフォームのウェブページとドキュメントを読み込み、開発者の評判や、良し悪しの傾向を示すほかのシグナルも追いかけました。
- エージェントオーケストレーションでは、グラフベースのアーキテクチャ上で単一エージェントもマルチエージェントも組める、わかりやすい考え方を重視しました。デバッグや可観測性の機能が充実していることも条件です。
- RAGでは、ドキュメントの取り込みや解析(使えるデータソースの連携や接続のしやすさを含みます)から、検索の制御をどこまで細かくできるかまで、パイプライン全体を評価しました。
- ワークフローで決め手になったのは、運用の基本となる要素です。リトライ、タイムアウト、実行条件などですね。ここでは、セットアップや保守の重さにも目を向けました。
- クラウドAIでは、プラットフォームの市場での強さと、使えるAI機能のそろい具合、そしてデプロイや保守のしやすさのバランスを見ました。
絞り込んだツールは、どれも実際に手を動かして試しました。入門用のプロジェクトを作り、環境を立ち上げ、最初のプロジェクトを広げながら、各プラットフォームならではのコア機能を試していきました。現実的に、すべてのツールを本番のあらゆる課題にさらすのは無理なので、未解決のIssueやコミュニティの議論、バグ報告にも深く目を通し、限界やエッジケースの扱いを把握しました。
jotform aiエージェントで、ワークフローを手軽に自動化しよう
オーケストレーションのパイプラインは、流し込むデータの質で決まります。エージェントが動き出す前に、まずきれいな入力を集める何かが必要で、そこで役に立つのがJotformです。Jotformのオンラインフォームを使えば、信頼できるデータ収集の窓口を作れます。これがカスタムエージェントやグラフを動かす出発点になります。
データ収集にとどまらず、jotform aiエージェントはAIによるワークフロー自動化のための本格的なエージェントプラットフォームです。LLMをナレッジベースにつなぎ、ツール呼び出しで外部システムに対して処理を実行できます。しかも、すべてがノーコードで完結します。つまり、あなたも、技術に詳しくないチームも、自社のデータを活かすエージェントをすぐに展開できるということです。カスタマーサポートに使ったり、AIによるプロジェクト管理に役立てたりできます。開発者のタスクを山積みにすることなく、AIによる業務プロセスの自動化を始められます。
この最前線のツール群には、豊富な連携先ライブラリとWebhook対応が備わっています。データを受け取ったら、そのまま後続の処理を動かせます。たとえば顧客管理(CRM)プラットフォームを更新したり、オーケストレーション層にイベントを送り込んだりといった具合です。Jotformをツールの一つに加えれば、インターフェースやユーザー体験の作り込みにかける時間が減り、本当に大事なロジックに向き合う時間が増えます。
あなたはどんなタイプのビルダー?
では、自分に合ったAIオーケストレーションツールはどう選べばいいのでしょうか。本番のAIシステムは、たいてい2つの層を必要とします。
- エージェントやRAGパイプラインの実行時の挙動を管理するもの
- その処理をスケジュールし、リトライし、継続して運用に乗せるもの
複雑な制御フローを持つステートフルなエージェントを作るなら、LangGraphはランタイム向けの最も優れたAIエージェントフレームワークの一つです。これに軽量なスケジューリング用のPrefectを組み合わせるか、既存のデータ基盤につなぐならAirflowと組み合わせるとよいでしょう。
マルチエージェントの連携なら、CrewAIを使えば動くプロトタイプにすぐたどり着けます。オーケストレーションの大部分も裏側で片付けてくれるので、規模を拡大するまでは、別途ワークフロー層を用意しなくても済むかもしれません。
RAGのシナリオでは、LlamaIndexは方針がはっきりしたエンジンなので、セットアップが速く進みます。一方のHaystackは立ち上がりこそ遅いものの、規模が大きくなるにつれてパイプラインをより強力に制御できます。どちらもPrefectと相性がいいです。
クラウドオーケストレーションについては、AWSとGCPのどちらを選んでも、柔軟性と引き換えにセットアップと保守の手間が大きく減ります。エージェントのランタイムまわりのインフラにずっと手をかけたくないチームには、これが一番の選択肢です。
まだピンとこないなら、チームにぴったりの組み合わせはこう選びましょう。まずランタイムをしっかり固め、何をオーケストレーションするのかが本当に見えてきたら、そこにAIワークフローのオーケストレーションを重ねていくのです。
この記事は、中級から上級の技術者に向けたものです。エージェントやRAGパイプライン、ワークフローのスケジューリングに使うオーケストレーションフレームワークを検討している、AI/MLエンジニア、開発者、データエンジニア、ソリューションアーキテクトを想定しています。













コメントの送信: